上周聊团队 Vibe Coding 时说,Agent 进团队要先改协同习惯。这周往下挖一层:协同理顺了,Agent 凭什么知道你的应用出了什么问题?
它知道什么是 OOM,能解释 JVM 内存结构。但你问它“凌晨三点告警的这个 Pod 是哪个应用、跑的什么版本、上周谁改的”,它未必答得上来。这些信息在公司的发布、配置、日志和代码系统里,得给它一条查得到、对得上的路。
我们这次先补的,就是这条数据链。已有的工具已经能支撑一些实际诊断,整体事件闭环还要继续验证。
通道接上了,问题还在
Kubernetes 通道接入后,Pod 的重启次数、退出原因、事件和上一次容器日志可以直接查,以前靠发布平台间接推测的部分,有了运行现场的证据。
但查到 Pod,仍然不等于认出了应用。它对应哪个模块、哪个仓库,生产镜像又对应哪个 commit,得继续跨系统找。项目的架构文档因此把主要瓶颈改写成了“服务身份解析、事件编排和跨信号关联”。
这一步让我更在意数据能不能对上。工具各自能查到东西,诊断却可能卡在两个工具之间。
先看一次实际诊断
9 月 30 日的一份大结果集告警报告,已经把日志和代码串到了一起。下面是公开脱敏摘录:应用、仓库、用户和业务代码名已匿名化,查询指标保留,原始 SQL、调用标识和业务明细不展示。
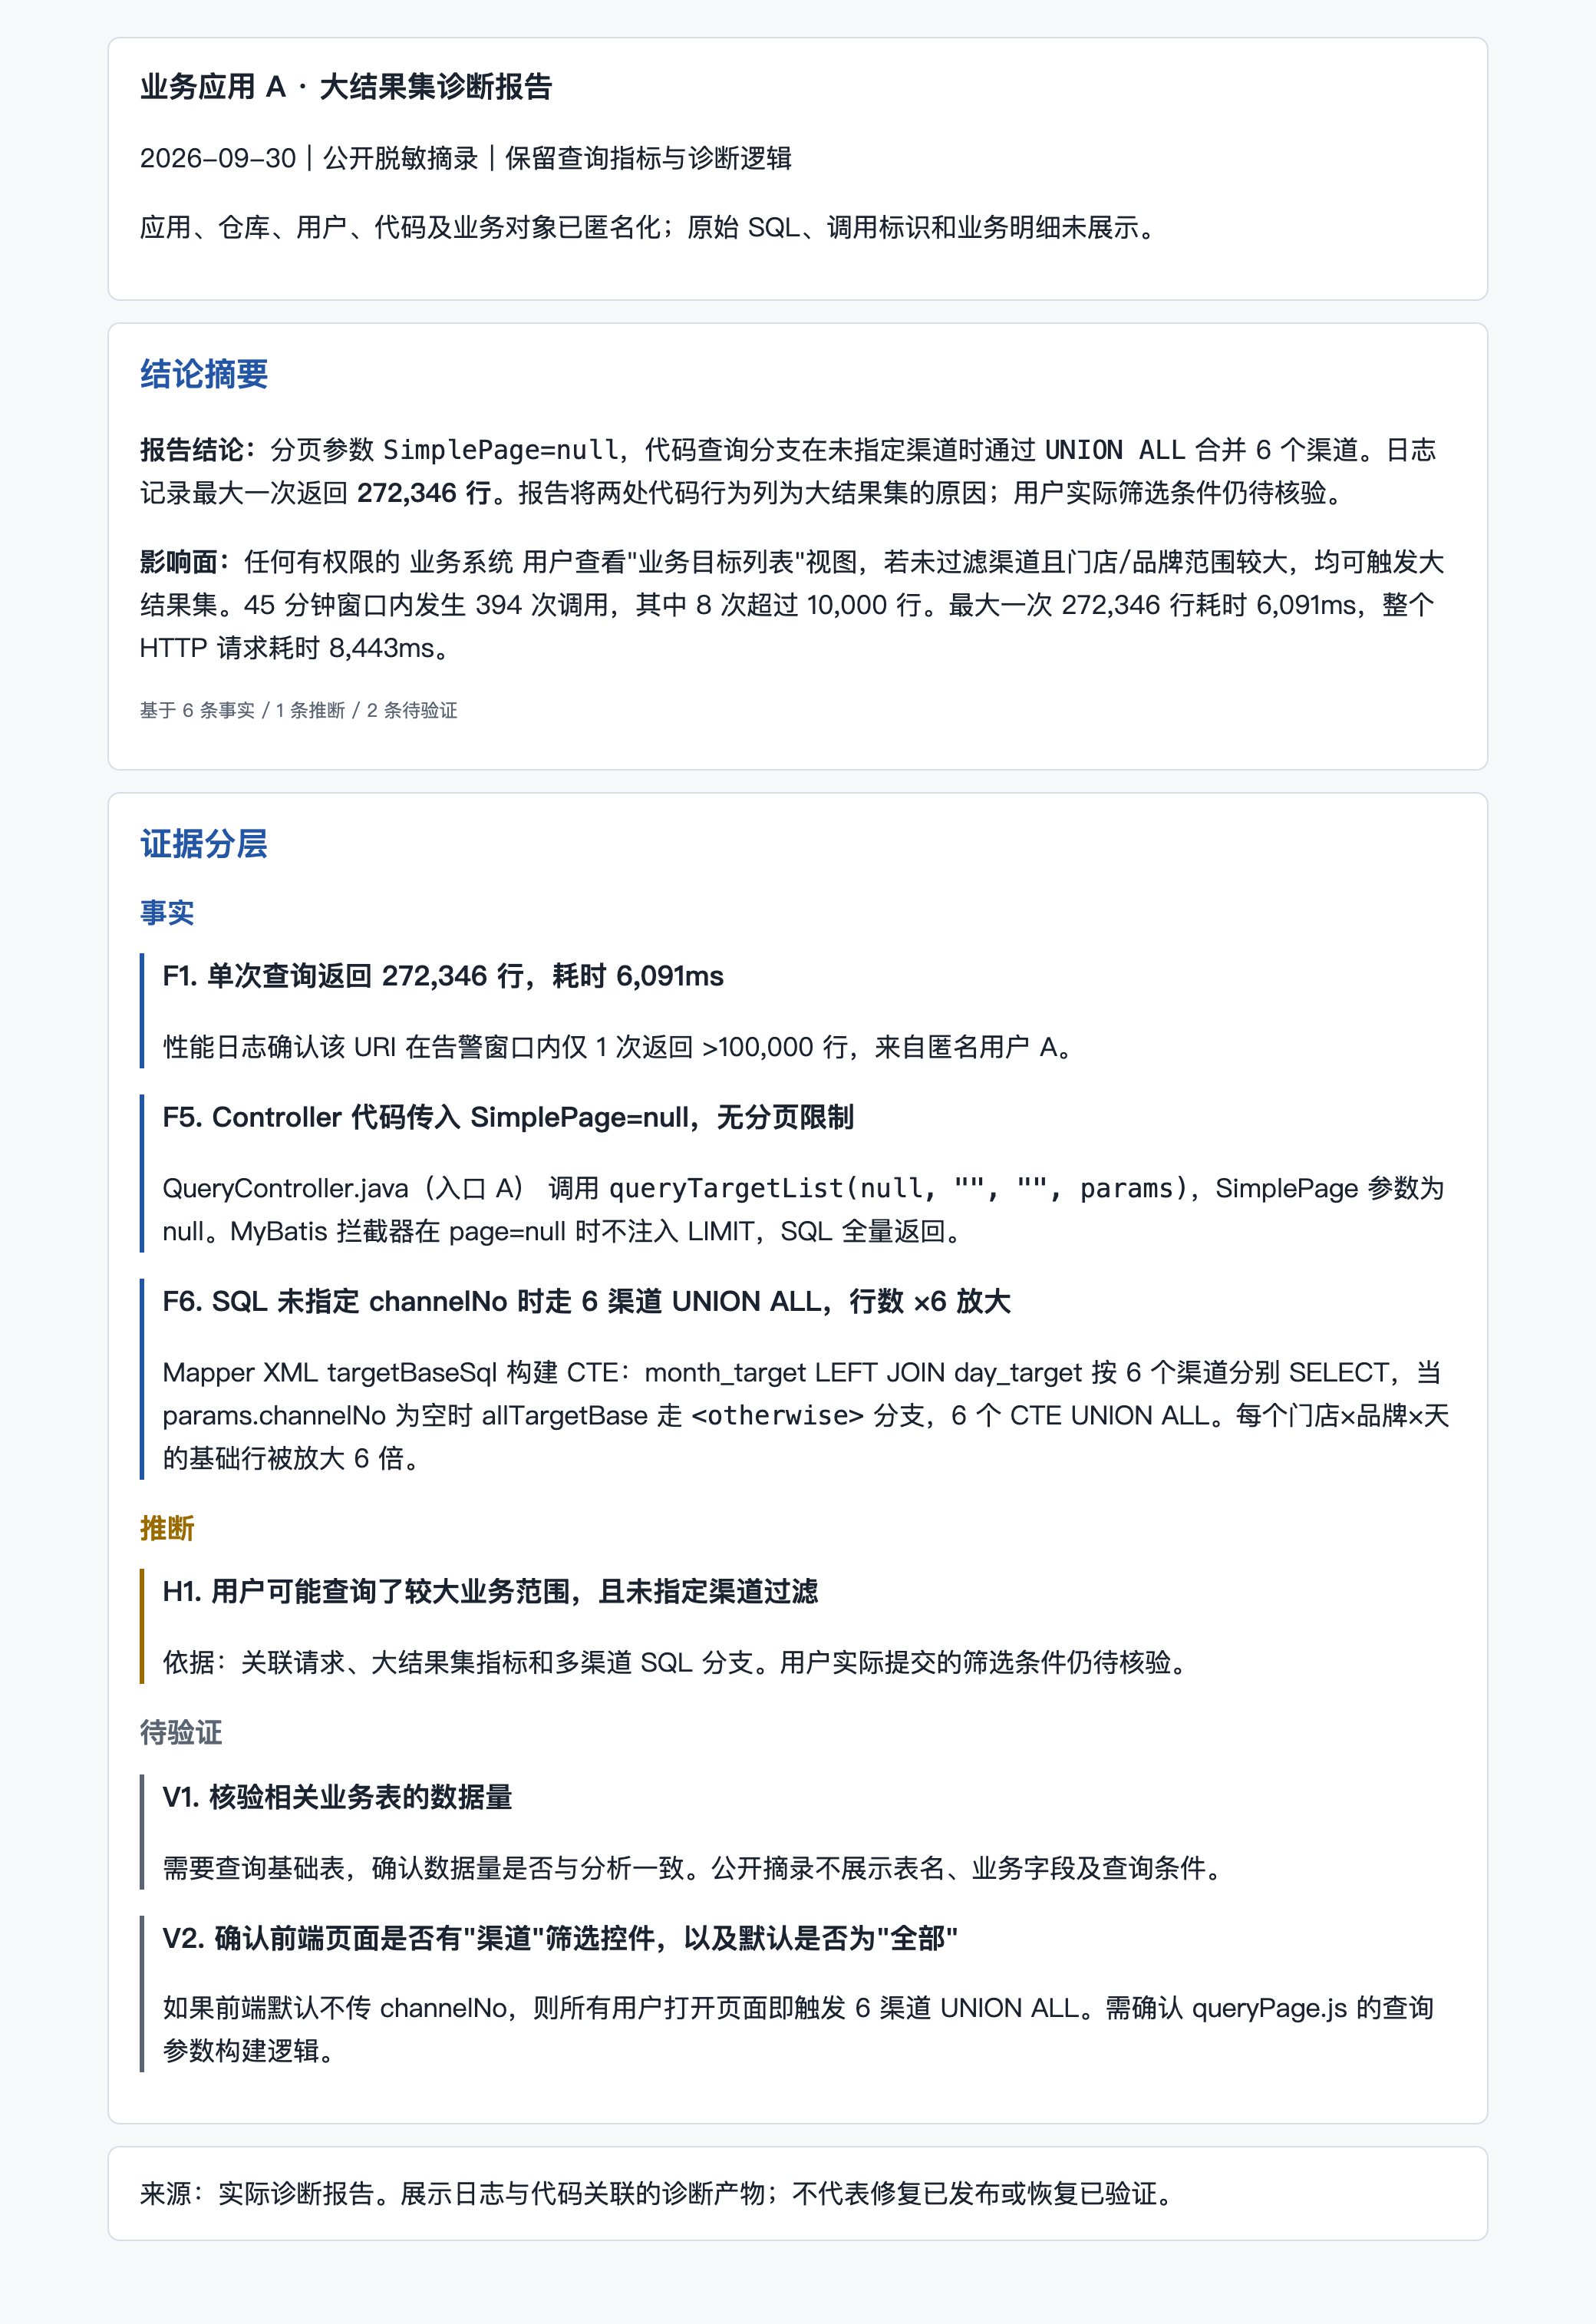
图 1:实际诊断报告的脱敏摘录。为适应文章阅读,仅保留结论与关键证据,未展示整份原始报告。
这次查出的最大一笔查询返回 272,346 行,数据库查询耗时 6,091 ms,整个 HTTP 请求耗时 8,443 ms。45 分钟的日志窗口内共发生 394 次调用,其中 8 次返回超过 10,000 行。
顺着请求查代码,报告找到了两处行为:调用入口把分页参数 SimplePage 传成了 null;未指定渠道时,SQL 用 UNION ALL 合并 6 个渠道的结果。大结果集有了可检查的代码解释,开发接手时也有了具体入口。
报告还留着待验证项:用户实际提交了哪些筛选条件、前端是否默认查询全部渠道、基础表数据量是否与分析一致。用户查了多大范围,属于推断,不能直接写进事实栏。
这里展示的是诊断产物:日志中的异常指标能追到代码行为,并且知道哪些问题还没查完。报告没有修复后的数据,也没有证明整个生产事件闭环已经完成。尤其是生产版本与代码证据是否绑定同一 commit,仍应在后续验收中单独核对。
从一条告警出发,一站一站铺
把研发环节摊开看,发布、配置、运行、日志、代码、数据库和 JVM 现场都有各自的系统。人查问题,在多个窗口之间切换,拿自己的记忆把对象串起来。Agent 要接手,就得把这层隐含关系补出来。
我们的做法是不新建一套大平台,尽量把现有能力接成原子工具。适合远程调用的能力通过 MCP 暴露,已有 CLI 也继续复用。MCP 负责工具接口,Skill 写使用规则,Skill Graph 控制流程分支和审批节点。我们否掉了把全部逻辑塞进一个人格化大 Agent 的方案:流程和权限都藏在 Prompt 里,出了问题很难审。
从告警走到代码,需要铺好下面几站。它们是取证顺序的参考,具体走哪一站要看症状和已有证据,不要求每次跑满。
第一站是身份。告警可能只给一个 Pod 名,先要知道它是谁。构建平台里有应用、模块、仓库和发布版本等资料;这些资料与 Kubernetes 的运行对象关联起来,才能固定诊断目标。完整的反向解析链仍是需要补齐的部分。
第二站是运行现场。Kubernetes 提供 restartCount、退出码、终止原因、Events 和 previous logs。Pod 是发布替换还是运行中退出,先查这些证据,不能只凭“重启了”三个字下结论。
第三站是日志。我们的日志落在 Doris 里,可以按时间窗查异常栈、错误码和请求分布。前面那份报告就是从查询行数和耗时入手,沿请求标识找到了关联调用。
第四站是变更。Apollo 提供配置读取与变更相关接口,发布记录回构建平台查。近期变更值得优先检查,但只能收窄怀疑范围。时间上挨着,不足以认定因果。
第五站是代码。GitLab 给版本库事实:commit、差异、MR 和流水线;基于 SCIP 的语义索引给定义、引用与调用关系。两类证据要绑定同一个 commit 才能合并结论,而且先固定生产版本对应的 commit,再查代码。拿主分支解释生产故障,可能从第一步就查错了版本。
第六站是更深的现场。前面的证据不够、目标 JVM 还活着,再考虑 Arthas,看线程、内存和慢调用。观察类能力先走,重资源操作和运行时修改按风险拦截。业务数据查询走 Archery,跨服务调用链走 Pinpoint;按当前项目资料,Pinpoint 的只读查询通道也已接入。
这些组件提供了各站的能力底座。环境接入、权限配置和跨系统关联,仍要在自己的工程现场逐项核验。
把各站的对象对起来
整体设计放在这张蓝图里。它描述目标结构,图中的事件控制面、共享记忆和学习闭环仍需实施与验证。
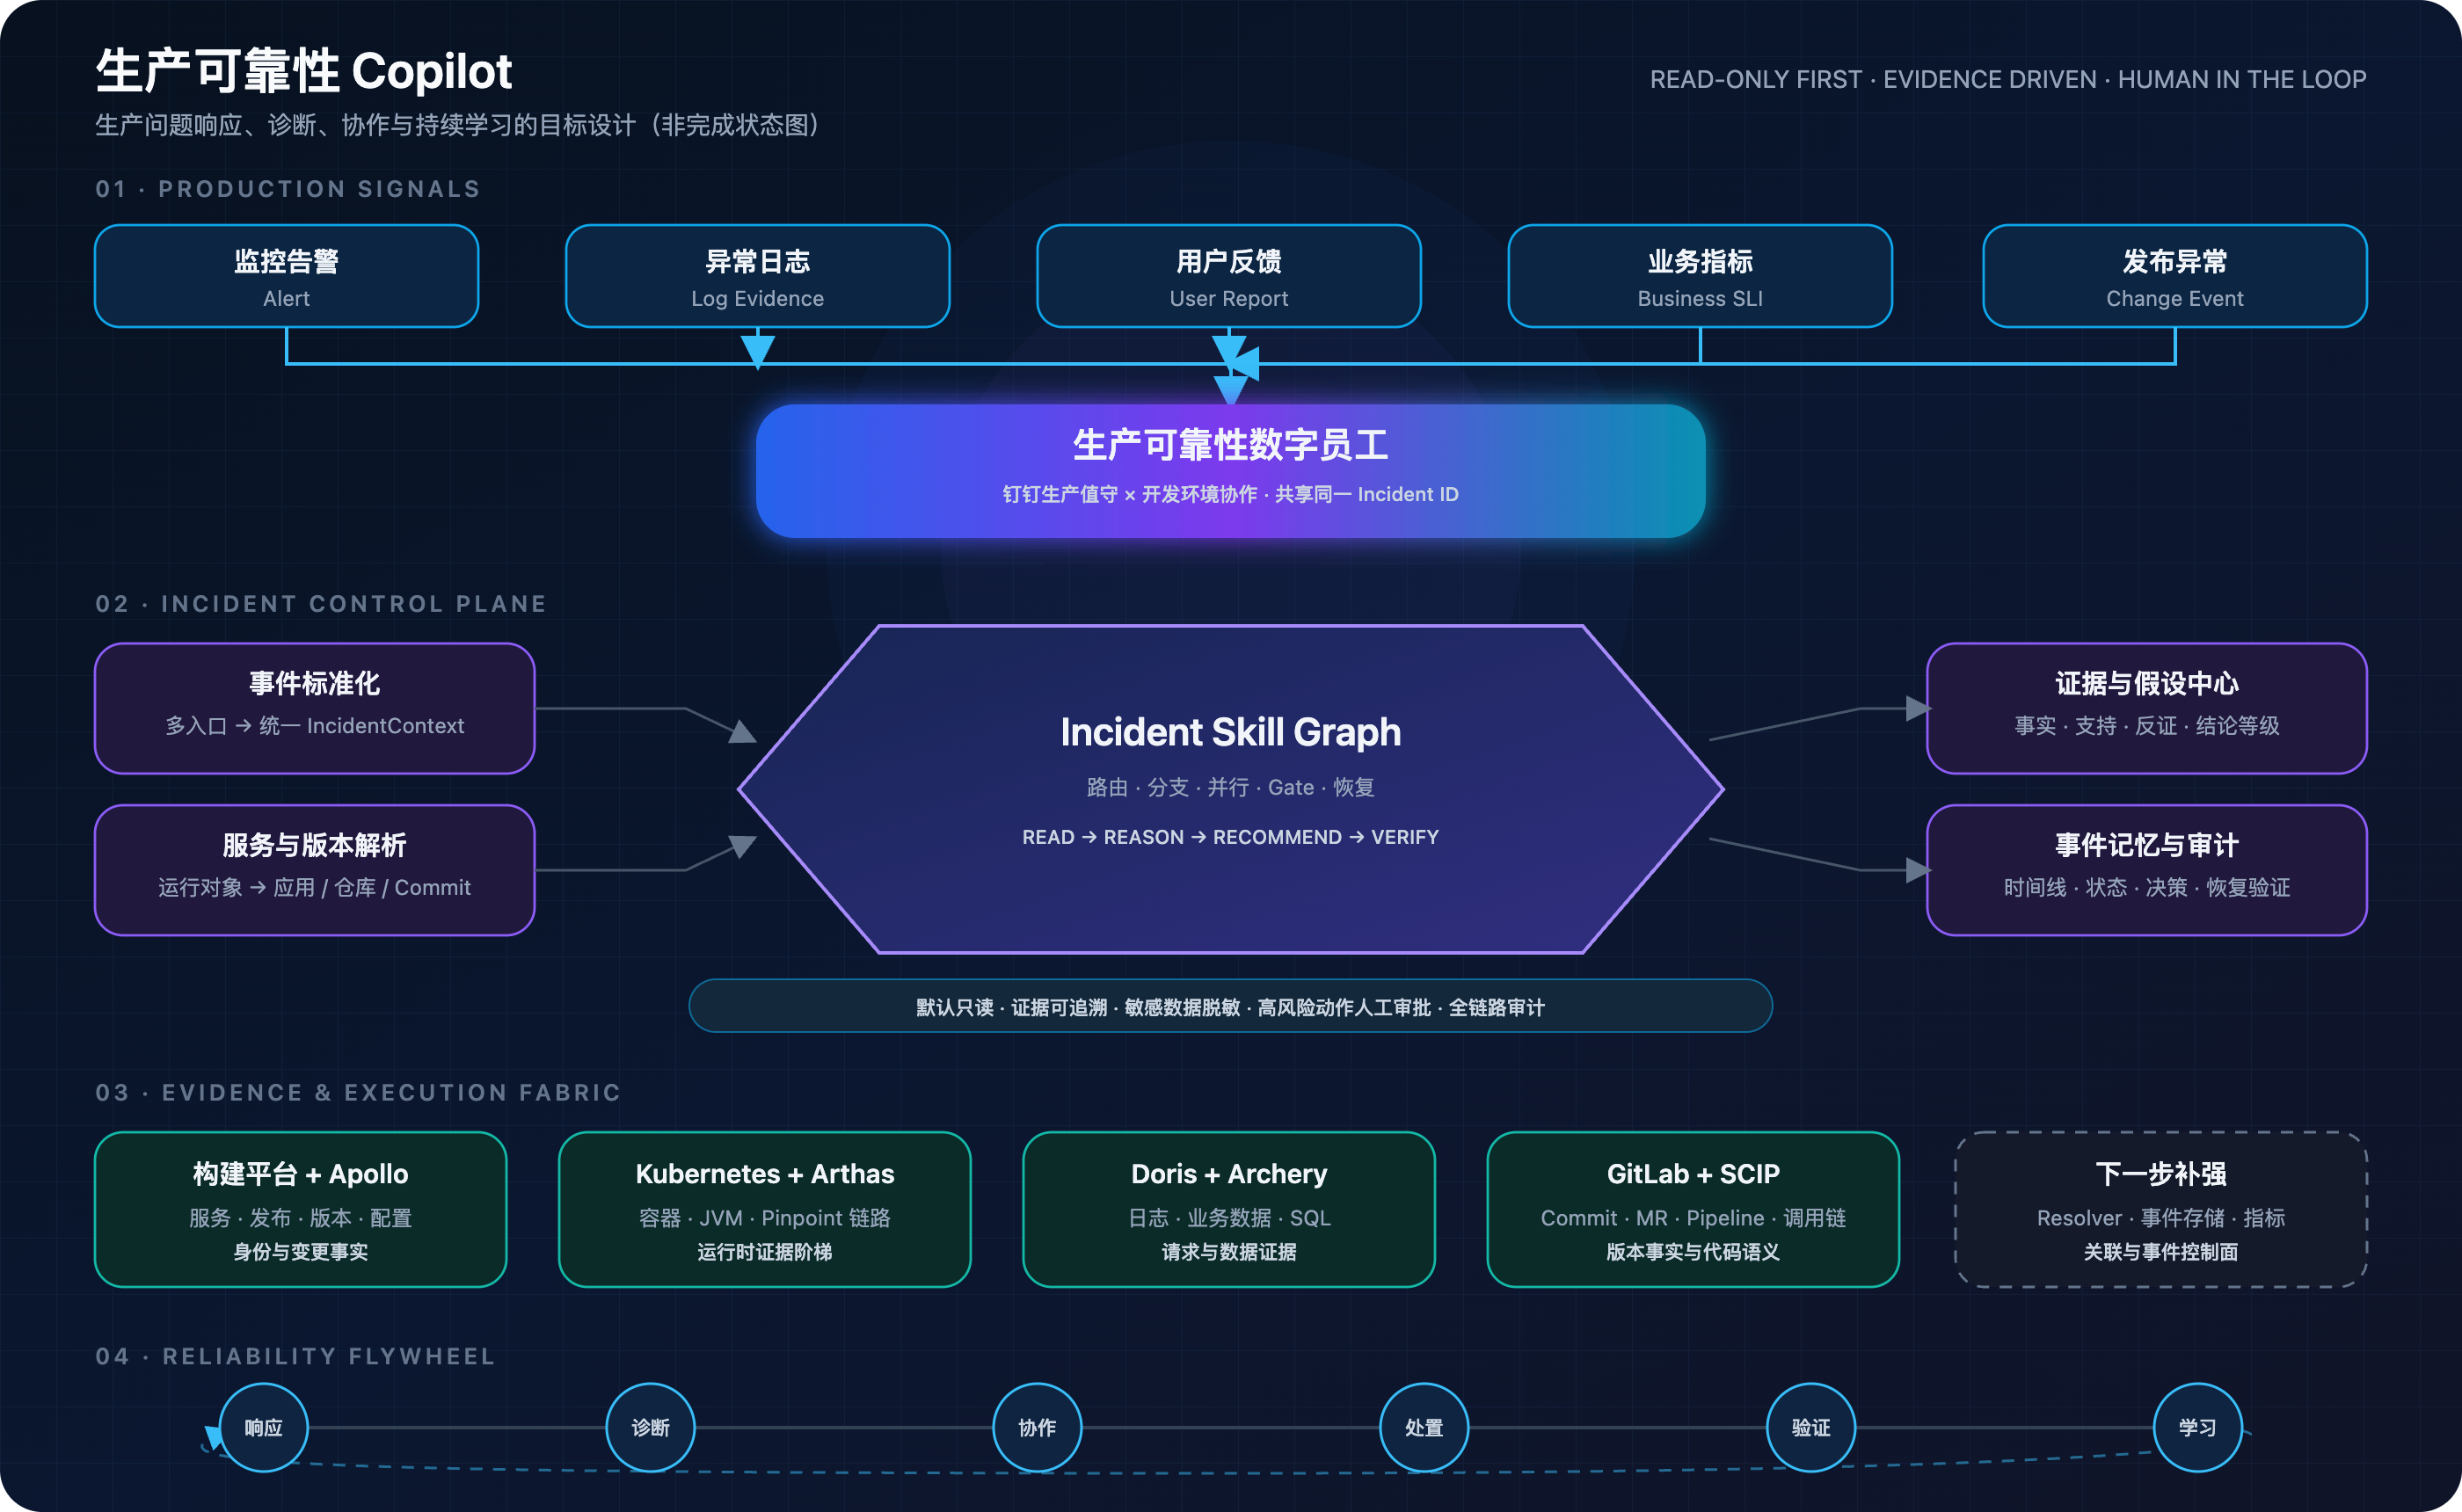
图 2:整体设计蓝图。构建平台承担身份与发布事实,底层工具提供证据,事件控制面负责关联、路由和审计;这张图不表示各模块均已完成。
最上面是告警、日志、用户反馈等问题入口,中间是统一事件和诊断流程,下面是各系统的查询能力。人工审批和证据追溯贯穿其中。要把这些层串起来,有三件事需要自己做。
一是身份解析。Kubernetes 认 Pod,GitLab 认仓库,Apollo 认应用。Pod 对到应用、再对到生产 commit,要靠企业自己的映射关系。由构建平台提供反向接口,还是写一个解析服务聚合,项目仍保留这个设计选择。
二是统一事件对象。告警、异常日志和用户反馈,进入后用同一种结构记录时间窗、影响面、证据、假设、动作和验证结果。工具查出的事实要落到事件里,后续换人、换会话都能接着查。正式存储也是需要落实的部分。
三是证据纪律。每条事实记来源、时间范围和查询条件;版本库事实与代码索引绑同一 commit;工具不可用、权限不足、数据为空、系统正常,四种结果分开写。一次查询没有结果,不能直接推出系统正常。
前面的报告也提醒了我们:诊断包里既要放支持结论的证据,也要保留没查完的部分。开发拿到它,才知道从哪里继续。
同一个事件,带到开发环境再带回来
我们设计的协作过程是:钉钉收到告警,建立事件 INC-001;值守侧诊断后,如果证据指向代码问题,开发在 IDE 里继续这个事件,接到问题摘要、日志时间线、生产版本、代码证据,以及已排除项和待确认问题。
定位、修复、构建和发布之后,再回到原始告警与业务指标验证。满足关闭条件,事件才关闭。共享事件对象和正式存储落地后,两侧才能持续接续这份上下文。
关闭的事件可以整理成 Runbook 和评测案例。下次出现相似症状,历史路径能提供查询起点,但应用版本和运行状态已经可能变化,结论仍要用当前证据重新验证。
先证明可信,再谈自动化
首阶段面向生产的交付范围是只读诊断和处置建议。回滚、重启、配置修改先给预览,由人审批执行。
一次实际报告,说明部分工具已经能串出有用的诊断。整体方案还要通过试点检查服务解析、事件流转和恢复验证。验收目标先立好:服务和环境识别率不低于 90%,5 分钟内形成有证据的初步诊断,事实 100% 可追溯,未审批的生产变更为 0。这些仍是目标数字,不是这份报告测出来的成绩。
告警平台接口、事件正式存储和完整生产权限边界,还需要落实。试点先看能不能认对应用,给出的判断能不能沿证据查回去。结果如何,跑完再说。
相关开源技术
下面按在这条数据链中的职责列出相关技术。MCP 服务、协议与底层系统分开列,方便找实现参考;构建平台和企业内部的语义索引服务不作为开源项目列入。
| 技术 / 项目 | 在本文方案中的用途 |
|---|---|
| Kubernetes | Pod、工作负载、事件与运行状态 |
| Kubernetes MCP Server | 将 Kubernetes 能力开放为 Agent 工具,服务端限制需按环境配置 |
| GitLab CE / GitLab MCP | 版本库、MR、流水线事实及其 MCP 接入 |
| MCP Toolbox for Databases | 通过预定义工具连接数据库及企业数据源,项目用于日志、构建平台等查询 |
| Apache Doris | 日志存储与 SQL 分析 |
| Apollo | 配置管理与配置变更证据 |
| Archery | SQL 查询、审核与工单 |
| Arthas | Java 运行时诊断 |
| Pinpoint | APM、跨服务调用链与事务证据;项目另有 MCP 接入服务 |
| SCIP | 代码索引协议,用于定义、引用等语义信息交换;本身不承担索引构建和托管 |
| Prometheus | 指标查询,为诊断与恢复验证提供信号 |
| TiDB | 相关业务数据库与数据查询 |
| Model Context Protocol | Agent 与外部工具之间的开放协议 |