文章目录
这段时间在探索 Agent 如何在企业内部落地。开源框架层出不穷:AgentScope、LangGraph、Claude SDK、Agno……每个都有自己的优缺点。看文档看得眼花缭乱,不如动手试试。
借助 AI,我用不同的 Agent SDK 把内部几个场景跑了一遍。跑的过程中,需求和关键技术点慢慢澄清,方向也逐渐清晰。这篇文章就是在这个过程中梳理出来的。还比较粗糙,但大方向应该差不多了,后续就是技术细节的澄清和实践。
一、定位:从助手到控制平面
很多人一开始把 Agent 系统定位成"智能助手"。听起来很美好,但这个定位有个致命问题:助手是服务个人的,企业要的是可控的系统。
我们做 POS 助手项目时,一开始也是这个思路。后来发现,如果只定位成"销售查询助手",架构就会往"能用就行"的方向走。权限随便传,SQL 让模型生成,审计日志可有可无。等要接入第二个业务场景,整个架构就得重来。
所以我们把定位改了:
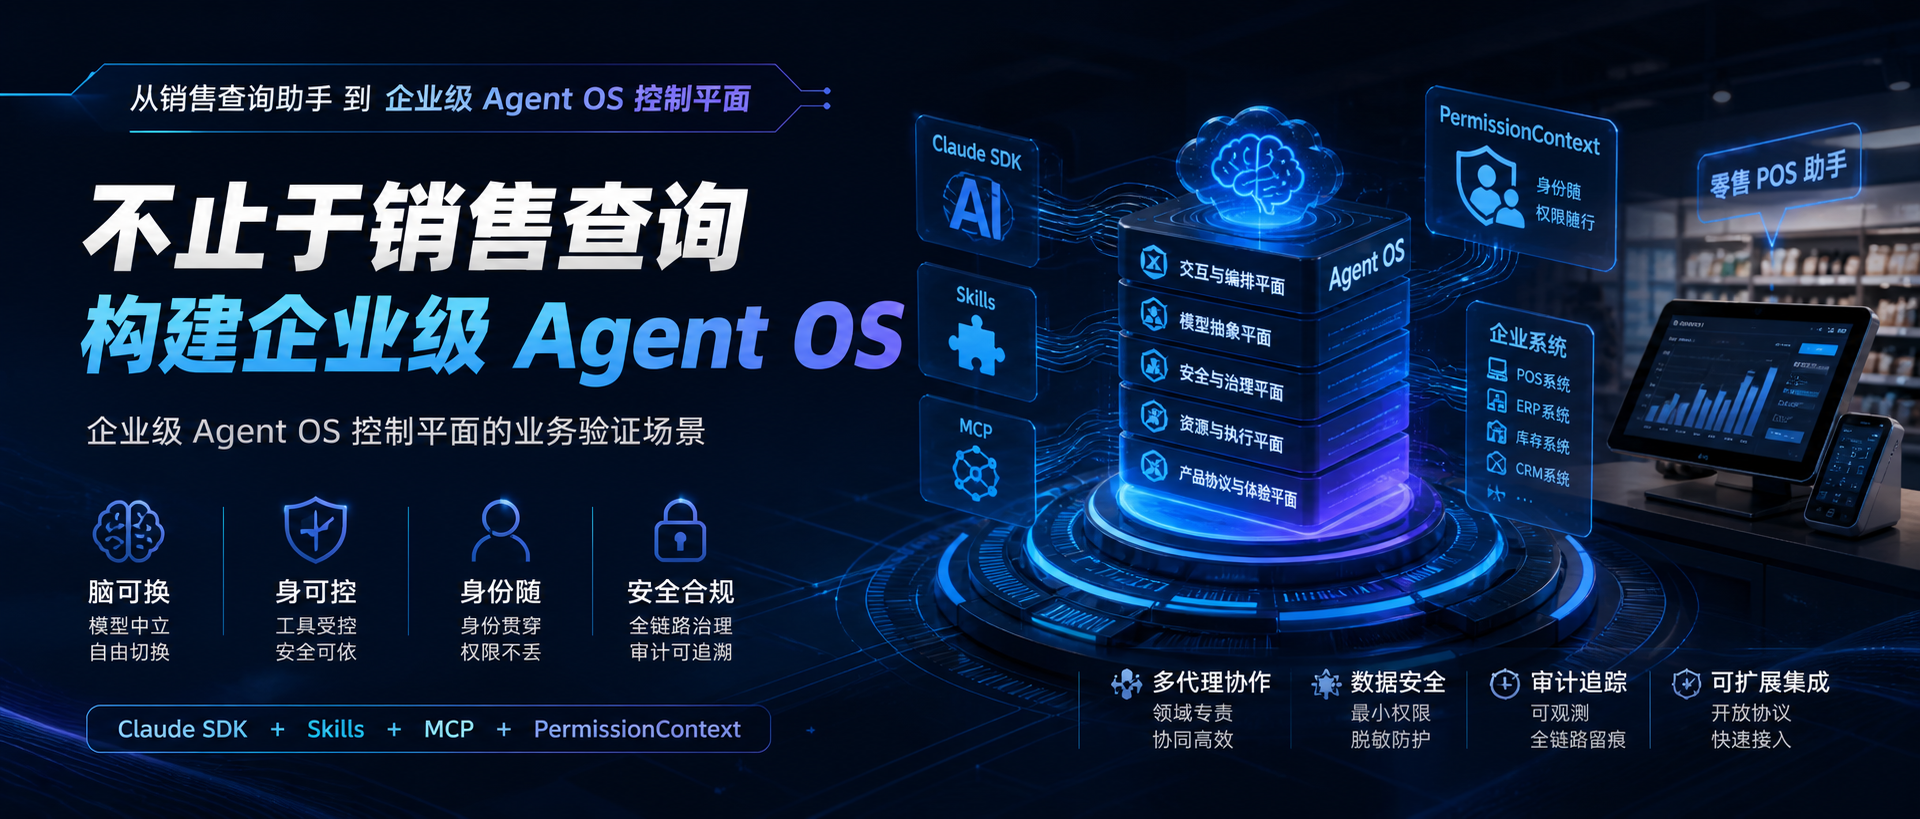
平台中立型企业 Agent OS 控制平面
宗旨:脑可换、身可控、身份随、安全合规
这四句话,每一句都是踩过坑才总结出来的。
脑可换:去年我们用 GPT-4,今年用 Claude,明年可能用 Gemini。模型供应商说变就变,业务架构不能跟着变。Prompt、工具定义、业务逻辑,这些不能绑死在某一个模型上。
身可控:Agent 调数据库、调 API、调遗留系统,这些操作必须走受控通道。不能让模型直接生成 SQL,不能让工具绕过权限层,不能让 RPA 在后台乱跑。
身份随:用户是谁、在哪个门店、有什么权限,这些信息必须从头到尾跟着请求走。不能在模型调用环节丢失,不能靠 Prompt 来传递,不能存到 conversationData 里。
安全合规:权限校验、审计追踪、数据脱敏,这些是控制平面的能力,不是模型的自觉。指望模型"自己知道不该查什么数据",是在赌运气。
二、五平面架构:不是分层,是分责
传统架构喜欢分层:展示层、业务层、数据层。Agent 系统不能这么分,因为每一层都有"控制"的职责。
我们把架构拆成五个平面:
| 平面 | 核心职责 | 一句话理解 |
|---|---|---|
| Product Protocol & Experience | 前端协议、流式交互、artifact | 别让前端从 Markdown 里猜图表 |
| Interaction & Orchestration | 会话、任务、记忆、多代理协作 | Agent 怎么持续工作 |
| Model Abstraction | 模型网关、协议适配、身份注入 | 模型供应商随便换 |
| Security & Governance | IAM、RBAC、审计、脱敏 | 出了问题能追责 |
| Resource & Execution | MCP、工具、数据库、知识库 | Agent 怎么操作企业系统 |
这五个平面,不是从上到下的调用链,而是五个独立的职责域。每个平面都有自己的边界和约束。
Product Protocol & Experience Plane
这个平面最容易被忽视。
很多团队直接把模型的文本输出返回给前端。前端拿到一串 Markdown,里面可能夹着代码块、表格、图表描述。前端工程师得写解析逻辑,从 Markdown 里猜这是什么类型的内容。
我们踩过这个坑。前端问:"图表数据在哪个代码块里?"后端说:"你找找 chart 关键字。"前端说:"找到了,但格式不统一。"后端说:"那我们改 Prompt。"改了 Prompt,旧数据又解析不了了。
后来我们定了一个硬规则:前端协议必须结构化。
{
  "content": "用户可读 Markdown",
  "artifacts": [],
  "conversationData": {}
}
content 只放用户可读的文本。图表、按钮、文件,这些增强信息放 artifacts。多轮任务状态放 conversationData。
前端不需要解析 Markdown,不需要猜格式。拿到 artifacts 里的 application/vnd.echarts+json,直接渲染图表。拿到 actions,直接渲染快捷操作按钮。
这个规则看似简单,但它把前后端的边界划清楚了。模型输出什么,是后端的责任;前端怎么渲染,是前端的责任。不要混在一起。
Interaction & Orchestration Plane
这个平面负责 Agent 怎么持续工作。
会话、任务理解、状态维护、记忆管理、多代理协作,这些都在这里。
我们一开始用 LangGraph 做 runtime。后来发现,LangGraph 的状态机太重了。每个节点都要定义,每条边都要显式声明。业务逻辑一变,状态图就得改。团队花了大量时间在调试状态流转上,而不是在解决业务问题上。
后来我们换了个思路:让 Claude Agent SDK 承担 agent loop,LangGraph 只在强一致流程里做局部引擎。
会话管理也是这个平面的大坑。
很多团队直接把 Claude session 当成业务会话。问题是,Claude session 是模型上下文的连续性,不是业务状态的连续性。用户换了门店、换了角色,Claude session 不会自动感知。
我们用两层会话来解决:
- Claude session:模型上下文连续性。
- conversationData:业务状态连续性。
conversationData 里存的是当前任务的状态、上次查询的结果、用户选择的门店。这些信息每次请求都要重新校验,不能依赖模型"记得"。
Model Abstraction Plane
这个平面的核心是:别绑死在一个模型上。
我们首期用 Claude Agent SDK,但业务代码不直接依赖 Claude SDK。我们定义了一个 AgentRuntime 抽象,所有业务代码通过这个抽象调用模型。
这样做的好处是:换模型时,只需要换 runtime 实现,业务代码不用改。
Prompt 也要解耦。业务规则不要写在 Prompt 里,要写在 MCP 工具和权限层里。
举个例子:店铺数据范围校验。如果写在 Prompt 里,模型"知道"要校验,但它可能忘,可能被绕过,可能在不同模型上表现不一致。写在 MCP 工具里,每次调用都强制校验,模型绕不过去。
身份跟随也在这个平面。
用户身份、租户、门店、角色,这些信息用 PermissionContext 对象传递。Python 用 contextvars,Node 用 AsyncLocalStorage。不要把 token 放进 Prompt,不要把 token 写进 conversationData,不要在日志里输出 token。
Security & Governance Plane
这个平面是企业的底线。
权限体系的核心是:PermissionContext 是唯一可信来源。
Authorization
    -> Permission Provider
    -> PermissionContext
    -> ClaudeAgentOptions.user
    -> MCP headers/env
    -> MCP tool enforcement
用户能查哪些门店的数据,来自 PermissionContext.shop_scope。用户在自然语言里说"查门店 A001 的数据",这个编码只能作为 requested_shop_no。requested_shop_no 必须和 shop_scope 做交集校验。权限不足,直接拒绝,不能降级为无过滤查询。
工具授权也是这个平面的事。
我们用 Claude SDK 的 allowed_tools 和 disallowed_tools 来控制工具可见性。高危工具(Bash、Write、Edit)不开放。通用数据库 MCP 不开放。MCP 工具白名单按角色动态生成。
审计追踪不能省。
每个请求有 X-Request-Id,透传到 Claude runtime、MCP、数据库。工具调用用 hooks 记录。SQL 在服务端日志里打印,但 token、API key 必须脱敏。用户看到的回复里,不能暴露 SQL、原始 JSON、内部状态。
Resource & Execution Plane
这个平面负责 Agent 怎么操作企业系统。
MCP 是核心。我们用 pos MCP server,工具命名 mcp__pos__query_sales。
数据访问有几个硬约束:
- Claude 不生成 SQL。
- MCP 工具接收业务参数,SQL 由代码构建。
- SQL 必须只读校验。
- 查询必须执行
PermissionContext.shop_scope过滤。 - 销售查询时间范围不超过 31 天。
这些约束写在 MCP 工具里,不是写在 Prompt 里。模型调用工具时,约束自动生效。
遗留系统和 RPA,首期不引入。没有 API 的系统,后续通过独立 RPA MCP server 接入。RPA 工具必须强制人工审批。
三、最小闭环:先跑通,再扩展
架构设计容易陷入一个误区:想得太全,做得太少。
我们定了一个原则:P0/P1 不做大平台,只做可验证闭环。
最小闭环是什么?
Frontend
  -> HTTP/SSE Protocol
  -> PermissionContext
  -> Claude Agent SDK
  -> Skill 领域知识
  -> MCP 业务能力
  -> {content, artifacts, conversationData}
验证场景就一个:
上周销售量按天统计,使用饼图显示
这个场景要验证五件事:
- Claude 能用 Skill 理解领域任务。
- Claude 能调用 MCP 业务能力。
- MCP 能基于
PermissionContext执行权限过滤。 - 图表返回 artifact,不塞进 Markdown 代码块。
- 多轮数据写入
conversationData。
这五件事跑通了,架构就立住了。然后再扩展第二个场景、第三个场景。
四、技术选型:立即用、预留接口、暂不引入
技术选型要分三类:
立即采用:Claude Agent SDK、MCP、PermissionContext、SSE、ECharts artifact。这些是首期必须有的。
预留接口:LiteLLM、OPA、OpenTelemetry、Milvus、Presidio。这些是中期可能引入的,先定义接口,不急着实现。
暂不引入:通用数据库 MCP、RPA、LangGraph 全局 runtime、复杂多模型路由。这些是首期不需要的,引入会增加复杂度,拖慢闭环验证。
五、关键决议:踩坑后的总结
最后,几个关键决议:
POS 助手是验证场景,不是架构边界来源。架构要服务企业级 Agent OS,不是服务一个助手。
Skill 是领域知识,不是业务执行层。业务执行在 MCP 工具里。
MCP 是业务能力,不是权限策略层。权限策略在 PermissionContext 和 OPA 里。
PermissionContext 是身份和数据权限的唯一可信来源。不要相信 Prompt,不要相信模型记忆。
Claude 负责推理和工具选择,不负责授权和 SQL。授权在权限层,SQL 在 MCP 工具里。
前端协议是独立平面,不从模型文本里反向解析业务结构。结构化协议,前后端各司其职。
平台化能力分阶段引入,先闭环,再扩展。别一上来就做大平台,先跑通一个场景。
做企业级 Agent 系统,技术不是最难的。最难的是守住边界:模型做什么、工具做什么、权限层做什么、前端做什么。边界不清,迟早失控。
把控制平面想清楚,代码写得慢一点,但心里踏实。出了问题能追责,换了模型能适配,加了场景能扩展。这才是企业级系统该有的样子。