总把 Agent.md 和 Skill.md 写混?问题不在 AI,在 A/B 没拆开
先分清目标与路径,再决定什么写进 Agent,什么沉淀成 Skill。
文章目录
壹:问题不在 AI,在 A/B 没拆开
这些年做技术,越到后面越会发现,很多问题表面看是工具问题,底层其实是表达问题。
我们总说 AI 不稳定,这次答对了,下次又跑偏了。可真往下挖,十有八九不是模型突然犯傻,而是我们自己没有把事情讲成一个完整链路。
这个链路其实很朴素,就是 $A \rightarrow B$。
- A 是起点:当前事实、上下文、约束、已有资产、风险边界。
- B 是终点:目标结果、验收标准、输出形式、不能碰的红线。
问题往往不在 A,也不在 B,而在中间那一段经常被省略的东西。很多人嘴上说“让 AI 帮我做一下”,脑子里其实只有一个模糊愿望,没有把从 A 到 B 的规则讲出来。
这也是为什么 AI 经常会出现三种典型跑偏:
- 只给了 A,没定义 B,于是它只能自己猜目标。
- 只给了 B,没交代 A,于是它在错误前提上一本正经地输出。
- A 和 B 都提了,但中间怎么判断、怎么取舍没写,于是它每次都按不同思路在做。
所以 A/B 理论不是一个漂亮说法,它更像一个很土、但很有效的工作方法:先把起点说清楚,再把终点说清楚,然后把中间的判断和执行拆开。
贰:A/B 解决的不是生成,是稳定
如果把 AI 看成一个执行系统,它每天都在做同一件事:
$$ \text{给定 A,依据规则,产生 B} $$
难点从来不是让它“做点什么”,而是让它在复杂现场里持续做对。
真实工作里的 A,通常都不干净。信息不完整,历史包袱很重,需求经常半路变形,代码能跑但结构很旧。B 也很少只是一个单一目标,更多时候是几件事同时成立:
- 既要改得快,也要避免回归。
- 既要补功能,也要符合团队规范。
- 既要自动化,也要可审计、可维护。
这时候,真正决定 AI 稳不稳定的,不是提示词写得多花,而是你有没有把两件事分开:
- 哪些是上层判断规则。
- 哪些是下层执行方法。
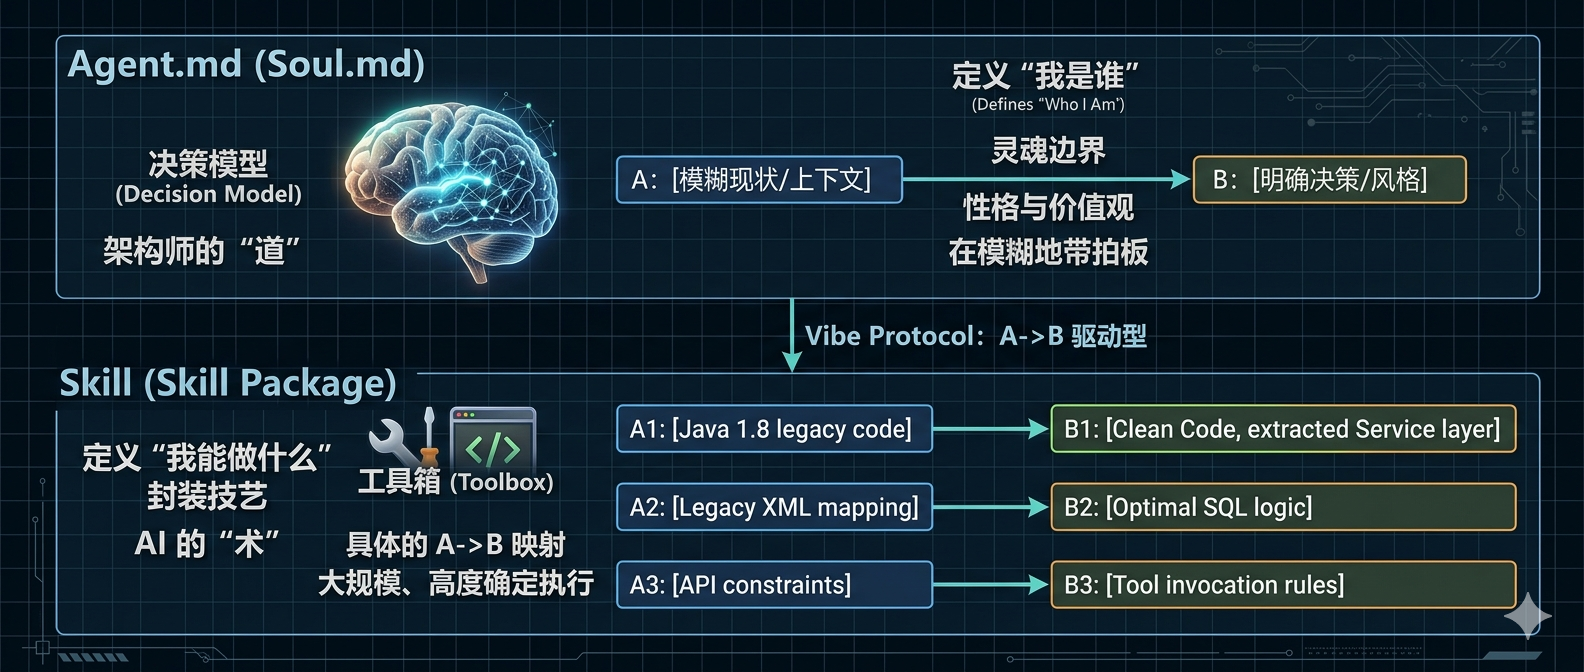
这正好就是 Vibe Coding 里两个最重要的文件:
- Agent.md 管判断。
- Skill.md 管执行。
这两个文件一旦写混,AI 就容易出现一种很熟悉的状态:像是懂了,其实没真正接住现场。
叁:为什么这两个文件总会写混
很多人写这两个文件时,表面上是在整理经验,实际是在把两层东西硬塞进同一个容器里。
一层是判断问题,比如:
- 信息不完整时,是先追问,还是先查现状。
- 代码能跑但很脏时,是先保守修补,还是顺手重构。
- 需求很急时,优先保护进度,还是优先保护结构。
另一层是执行问题,比如:
- 要做影响面分析,先搜什么,再读什么,最后怎么输出。
- 要整理需求,先提取事实,还是先组织结构。
- 要定位报错,先看日志、调用链还是数据库。
前一层是在回答“怎么判断”,后一层是在回答“怎么完成”。
这是两个完全不同的 A/B 映射。
Agent.md 对应的 A 和 B
- A:一个复杂、模糊、带冲突的工作现场。
- B:在这个现场下,Agent 应该采取的策略、优先级和行为边界。
Skill.md 对应的 A 和 B
- A:一种明确的任务输入。
- B:一种可验证的任务输出。
说得直白一点:
- Agent.md 规定脑子怎么转。
- Skill.md 规定手上怎么做。
肆:先记住这一条分界线
很多人最卡的地方,其实就一句话:
一条规则,到底该放 Agent.md,还是 Skill.md?
判断方法不用复杂,越朴素反而越稳。
- 如果这句话在回答“遇到复杂情况时该如何取舍”,放进 Agent.md。
- 如果这句话在回答“遇到某类任务时该按什么步骤完成”,放进 Skill.md。
再换个更接地气的说法:
- 偏判断、偏取舍、偏风格、偏边界的,放 Agent.md。
- 偏流程、偏步骤、偏输入输出、偏复用的,放 Skill.md。
比如:
- “修改老系统前,优先做影响面分析,不要先重构。”这是 Agent.md,因为它定义的是决策倾向。
- “分析影响面时,先找调用链,再找数据库表,再列出接口影响。”这是 Skill.md,因为它定义的是执行步骤。
前者定方向,后者来落地。
伍:放进真实场景,问题就清楚了
如果文章写到这里就停,还是容易飘。很多人看概念的时候觉得自己明白,一到真写文件,手又开始乱。
那就不绕了,直接设一个真实感强一点的场景。
假设你接手一个用了八九年的 Java 单体项目,代码不新,文档不全,产品给了一个需求:
给订单模块增加“按渠道导出对账单”的能力。
这类需求,老工程师一看就知道,麻烦的从来不是“导出”两个字,而是背后那一串不确定性:
- 订单数据散落在哪几张表里。
- 现有导出逻辑有没有可复用实现。
- 新导出会不会拖垮线上查询。
- 字段口径是不是和财务现在用的一致。
- 这是局部加功能,还是会牵出一串历史模块。
你会发现,这里面天然就混着两类问题。
一类是判断问题:面对老系统、缺文档、时间紧的现场,到底怎么取舍。
另一类是执行问题:一旦决定推进,应该按什么顺序把入口、调用链、数据口径、风险点跑清楚。
这就是 Agent.md 和 Skill.md 最典型的分工现场。
陆:Agent.md 写判断,不写动作
先看 Agent.md。
这里最容易犯的错,是一上来就写“怎么导出 Excel”。这不对。Agent.md 不是教 AI 点哪几个按钮,也不是教它先查哪个类。它要解决的,是更上层的判断问题:
- 老系统里要不要顺手重构。
- 信息不全时,是先问还是先查。
- 改动赶时间时,优先保护什么。
- 遇到口径冲突时,以什么为准。
放到 A/B 理论里看,就是:
- A:一个信息不完整、结构老旧、风险不透明的需求现场。
- B:Agent 在这个现场里应该采取的策略,比如先查现状、优先局部修复、谨慎处理口径冲突、避免无授权重构。
也就是说,Agent.md 产出的不是功能代码,而是做事姿势。
写出来,大概应该是这个样子:
# Agent.md

## Role
你是面向企业老系统交付的 AI 编程助手,优先保证需求落地、影响可控、口径一致。

## Core Goals
1. 先确认业务口径,再推进实现。
2. 先控制风险,再追求结构美观。
3. 优先复用现有能力,避免无必要重构。

## Decision Rules
- 遇到老系统需求时,先识别现有实现和影响范围,再决定是否新增或修改。
- 当用户目标明确但实现路径不明确时,先调研代码现状,再给出方案,不直接生成大段代码。
- 当数据字段存在歧义时,优先保留待确认项,不擅自猜测业务口径。
- 当需求时间紧、系统历史包袱重时,优先做局部可验证修改,除非用户明确要求统一治理。
- 当发现潜在性能风险时,先提示风险和影响点,再继续实现。

## Boundaries
- 不因为“顺手优化”扩大改动范围。
- 不在没有依据的情况下重命名历史字段或重构核心流程。
- 不跳过验证步骤就宣称功能可上线。

## Collaboration
- 如果信息缺失但仍能推进,先给出最小可行方案,并标注待确认问题。
- 如果缺失信息会直接影响正确性,先暂停实现并说明缺口。
看到这里,其实就能明白它为什么该放在 Agent.md。因为它回答的不是“怎么做导出”,而是“在这种现场下应该怎么判断”。
哪怕需求换成“增加审批节点”“补一个报表接口”“修一个历史 bug”,这些规则照样成立。这就说明,它们不是某个任务的步骤,而是一类工作的判断底盘。
柒:Skill.md 写闭环,不写原则
当 Agent 把上层判断定下来,下一步才轮到 Skill.md。
这里不要写一个什么都想包住的大 Skill。最稳妥的办法,是围绕刚才的现场,先抽出一个明确任务。
比如这个例子里,最自然的 Skill 就是:
老系统新增需求的影响面分析 Skill。
它的目标不是直接交最终代码,而是先把需求落地前必须搞清楚的东西走一遍。
放到 A/B 理论里,就是:
- A:一个新增需求说明,加上一套不完全透明的历史系统。
- B:一份结构化的影响面分析结果,包含入口、调用链、数据表、复用点、风险点和待确认项。
这里的 B 已经不是策略,而是一个可以交付、可以验收的结果物。
写出来,大概是这样:
# Skill.md

## Name
老系统需求影响面分析 Skill

## Trigger
当用户要在历史项目中新增或修改功能,需要先判断改动范围、复用点、风险点时调用。

## Input
- 需求描述
- 相关模块名称、接口名、页面名或关键词
- 项目代码仓库或可搜索的代码上下文

## Output
- 一份结构化影响面分析
- 至少包含以下内容:
    - 功能入口
    - 相关服务与调用链
    - 涉及的数据表或核心对象
    - 可复用实现
    - 风险点
    - 待确认问题

## Steps
1. 从需求描述中提取业务关键词、模块名称和可能的入口位置。
2. 搜索现有代码中与该需求最接近的接口、Service、Mapper、SQL 或页面逻辑。
3. 梳理从入口到持久层的主要调用链,标出关键类和方法。
4. 找出涉及的数据表、查询条件、字段口径和导出格式。
5. 识别可复用逻辑,以及新增改动最可能落点。
6. 评估性能、数据一致性、兼容性和测试回归风险。
7. 输出结构化结论,并单独列出无法确认但会影响实现正确性的问题。

## Fallback
- 如果找不到直接对应实现,则寻找相邻业务流程作为参照。
- 如果代码上下文不全,则先输出已确认部分,并明确缺失边界。

## Done
当分析结果足以支持进入方案设计或代码修改阶段时,视为完成。
这段内容为什么该放在 Skill.md,也很清楚。因为它定义的是一个稳定的执行闭环:
- 什么时候触发。
- 需要什么输入。
- 结果要长什么样。
- 按什么顺序推进。
- 信息不够时怎么办。
这些不是价值判断,而是可以反复调用的任务模板。
捌:真正好用的地方,在于这两层能接上
很多人以为只要写了 Agent.md,或者堆了一堆 Skill.md,AI 就会自然变强。其实不是。真正决定效果的,是这两层能不能接起来。
还是刚才那个需求,如果让 AI 按一条完整链路跑,过程大概是这样的:
- 用户提出需求:订单模块新增按渠道导出对账单。
- Agent.md 先判断这是老系统新增需求,不应直接大改,也不能直接凭感觉写代码。
- Agent 根据自己的决策规则,优先调用“影响面分析 Skill”。
- Skill.md 按既定步骤输出分析结果,找出入口、调用链、数据表和风险点。
- Agent 再根据分析结果做下一层判断:是直接局部改造,还是先补口径确认,还是先提示性能风险。
这里最关键的一句是:
Agent.md 决定下一步该做什么,Skill.md 负责把这一步做扎实。
这才是一条完整的 A/B 链路。
玖:最常见的错,不是少,是混
很多文档看起来写得不少,实际上不好用,问题通常不在写得少,而在写得混。
比如有人会这样写:
- 保持严谨
- 充分理解上下文
- 优先考虑系统稳定性
- 使用 grep 搜索相关代码
- 阅读 Service 和 Mapper
- 输出分析报告
这类写法一眼看过去没毛病,实际上问题很大。前面三条是原则,后面三条是步骤,根本不是一个层级的东西。
如果全塞进一个文件,结果往往是:
- 原则不够硬,执行时起不到约束作用。
- 步骤不够完整,复用时又不够稳定。
最后 AI 就会呈现出一种很熟悉的状态:像是理解了,做出来却总差一口气。
除了混写,还有两个常见问题。
1. 把原则写成口号
像“高质量输出”“尽量专业”“保持严谨”这种话,看起来都对,执行起来几乎没用。因为它们不可观察,也不可判断。
真正有效的写法,应该尽量能落到行为上,比如:
- 修改前先定位根因,不直接根据报错表面修补。
- 输出结论前说明依据。
- 无法验证时明确标注未验证,而不是默认完成。
2. 把步骤写得像流水账
如果 Skill.md 只是机械罗列动作,没有输入、输出、异常处理和完成判据,那它也很难稳定复用。流程不是越长越好,而是要形成闭环。
拾:两个问题,帮你快速判断
如果你还是拿不准某一句该放哪,就问自己两个问题:
- 这句话是在规定“怎么判断”,还是在规定“怎么执行”?
- 换一个任务它还成立吗?
通常来说:
- 规定怎么判断的,进 Agent.md。
- 规定怎么执行的,进 Skill.md。
- 换一个任务还能成立的,多半是 Agent.md。
- 只对某类任务稳定有效的,多半是 Skill.md。
这个方法不花哨,但特别像这些年做技术积累经验的方式。很多真正有分量的工程判断,本来就不是靠华丽术语记住的,而是靠一次次现场把边界磨出来的。
拾壹:最后说点实在的
Vibe Coding 最大的问题,从来不是 AI 不会写,而是人太容易把任务交给一种“感觉”。
感觉当然有价值。很多老工程师一眼看过去,就知道哪里可能有坑,哪里不该动,哪里应该先查口径。这种东西很难得。但如果它一直只停在脑子里,那它就只能服务你自己,不能沉淀,不能复用,也传不下去。
A/B 理论的价值,就在于逼着我们把这些手感翻译成结构:
- 起点是什么。
- 终点是什么。
- 中间依据什么做判断。
- 哪些规则是长期稳定的。
- 哪些步骤是某类任务专用的。
前者写进 Agent.md,后者写进 Skill.md。
等你把这两件事真正分开,AI 才不只是一个“你说一句它猜一句”的助手,而是开始像一个能接工程现场、能接住多年经验的人。
说到底,写 Agent.md 和 Skill.md,写的不是格式,写的是你这些年做技术留下来的判断力和手艺。