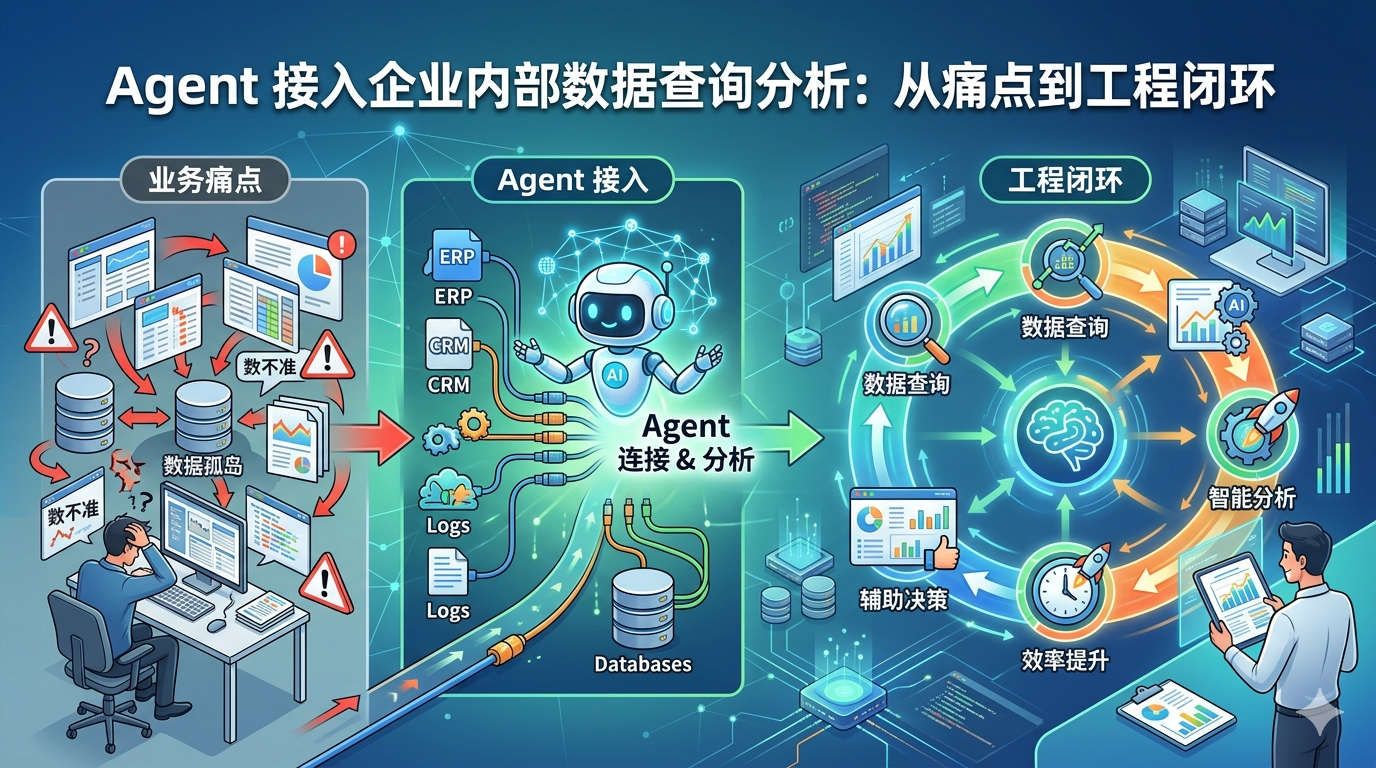
企业内部的数据查询分析,很容易被简化成“自然语言转 SQL”。用户问“最近一周的退货情况,按商品、尺码分组汇总退货金额和退货数量,按照金额倒排序”,Agent 生成 SQL,查库,返回表格,表面看链路就完成了。
但真实系统里的问题通常不在“SQL 能不能执行”,而在“结果是不是符合业务预期”。我们在零售 POS 助手里遇到过一个典型问题:用户明确要求退货金额和退货数量,系统只返回了数量;用户要求按商品、尺码分组,结果只按商品分组,尺码丢了。接口成功,数据库也返回了数据,但业务结果是错的。
这个问题暴露出一个更底层的矛盾:企业数据查询 Agent 不能只靠模型临场写 SQL。它要同时处理业务口径、权限边界、多轮状态、查询质量和后续复盘。模型可以理解用户想要什么,但不能把原始数据库、权限判断和业务口径都交给模型自由发挥。
这里先明确架构边界。本文讨论的是 Agent OS 能力层里的 Data Query 插件,不是把 Agent OS 的通用 Planner 定义成报表设计器。Agent OS 平台层仍然负责通用的任务规划、能力选择、Session、TaskState、Policy、Audit、Observability 和插件治理;数据查询只是其中一个重点能力场景。
所以在 Data Query 插件内部,我们把方案从“模型生成 SQL”调整为“Query Planner 生成查询规格,系统受控编译 SQL”。这个设计更接近 Kibana 报表:CTE 像一个受控索引,YAML 像索引字段和指标目录,Query Planner 像查询规格生成器,SQL builder 像查询编译器,执行链路负责权限、执行、观测和反馈。
下面用一个完整问题贯穿这条链路:
最近一周的退货情况,按商品,尺码分组汇总退货金额和退货数量,按照金额倒排序
下面所有 SQL、YAML、字段名、表名、状态值和门店号都使用脱敏示例命名,只表达工程结构和链路关系,不对应真实生产库命名。
在 2026-05-03 执行时,“最近一周”会被解析为 2026-04-27 到 2026-05-03。这个例子覆盖了多个容易出错的点:多指标、多维度、指标排序、时间范围、门店权限和质量追踪。
第一个节点是 Data Query 插件内部的 Query Planner。它不直接输出 SQL,而是输出一个结构化查询规格。
这个节点解决的问题是“用户说的是自然语言,但执行层需要稳定契约”。如果 Agent OS 只选择了一个 capability,例如 sales.return_analysis,后面的工具仍然要重新猜指标、维度和排序,问题会再次分散到工具内部。Query Planner 需要在这个 capability 内,把用户问题拆成稳定的 ReportSpec。
下面的 JSON 展示的是当前实现里的统一 PlannerDecision 载体:selected_capabilities 属于 Agent OS 层面的能力选择,report_spec 属于 Data Query 插件内部的查询规格。工程上可以放在同一个结构里传递,但架构表达上要区分这两层。
这个问题对应的计划应该接近下面这样:
{
  "task_type": "new_task",
  "resolved_intent": "退货数据分析",
  "selected_capabilities": [
    {
      "type": "tool",
      "name": "sales.return_analysis",
      "priority": 100
    }
  ],
  "slot_update": {
    "task_relation": "new_task",
    "selected_capability": "sales.return_analysis",
    "status": "ready",
    "slot_updates": {
      "report_spec": {
        "source": "return_topic",
        "capability": "sales.return_analysis",
        "metrics": ["退货金额", "退货数量"],
        "dimensions": ["product", "size_code"],
        "sort": [
          {
            "field": "退货金额",
            "order": "desc"
          }
        ],
        "time_range": {
          "start_date": "2026-04-27",
          "end_date": "2026-05-03",
          "keyword": "最近一周",
          "days": 7
        },
        "limit": 20
      },
      "metric_type": "退货金额,退货数量",
      "group_by": "product,size_code",
      "sort_by": "退货金额",
      "sort_order": "desc"
    }
  },
  "need_clarification": false
}
这里有几个关键点。metrics 必须保留两个指标,不能把“金额和数量”压缩成一个字段;dimensions 必须保留 product 和 size_code 两个分组,不能只留下商品;排序字段保留用户原话里的“退货金额”,后面由元数据解析到受控指标;兼容字段 metric_type、group_by、sort_by 只是为了旧链路兼容,真正的主契约是 report_spec。
第二个节点是 CTE 受控数据面。它解决的问题是“模型不应该直接面对原始业务库”。
退货分析底层涉及 biz_return_header 和 biz_return_line。如果让模型直接查原始表,它需要自己判断主明细 join、有效状态、退货业务类型、统计日期、退货金额字段和门店权限。任何一个判断错了,结果都会偏。
当前退货数据面通过 resources/ctes/return_topic.sql 固化:
WITH return_topic_cte AS (
    SELECT
        h.return_doc_id,
        h.store_id,
        DATE(h.return_date) AS return_date,
        h.doc_status,
        h.return_type,
        l.product_code,
        COALESCE(NULLIF(l.product_name, ''), l.product_code) AS product_name,
        l.size_code,
        l.brand_code,
        l.brand_name,
        l.category_code,
        l.return_quantity,
        COALESCE(l.return_net_amount, l.fallback_amount, 0) AS return_net_amount
    FROM biz_return_header h
    INNER JOIN biz_return_line l ON l.return_doc_id = h.return_doc_id
    WHERE h.store_id IN :store_scope
        AND DATE(h.return_date) BETWEEN :start_date AND :end_date
        AND h.return_type = 'RETURN'
        AND h.doc_status IN ('COMPLETED', 'SHIPPED', 'CLOSED')
)
这个 CTE 里面已经固定了几类业务规则:只看授权门店 store_scope,时间条件由服务端参数注入,只看 return_type = 'RETURN' 的退货,只统计脱敏示例中的有效状态 COMPLETED/SHIPPED/CLOSED,退货金额统一取 return_net_amount,缺失时回退到 fallback_amount。这就是“受控数据面”的意义:Query Planner 生成 ReportSpec 时看到的是 return_topic_cte,不是整个 POS 原始库。
“尺码分组丢失”的问题也落在这个节点上。早期 CTE 如果没有暴露 size_code,Query Planner 即使理解了用户要按尺码分组,SQL builder 也不能合法生成 GROUP BY size_code。修复方式不是让模型猜 biz_return_line.size_code,而是把 size_code 加入 CTE 输出字段和字段目录。这样尺码才真正成为系统支持的分析维度。
第三个节点是 CTE YAML 元数据。它解决的问题是“字段存在,但系统还需要知道字段的业务语义”。
return_topic.yaml 里会把 CTE 输出字段、指标、维度和 capability 绑定起来。下面是和这个案例直接相关的配置节选:
name: return_topic
label: "退货换货"
description: "退换货单主表+明细表联合查询,支持按日期、商品维度分析退货金额、退货数量、退货单数"

columns:
  - name: return_doc_id
    description: "退换货单号"
    type: string
  - name: store_id
    description: "门店编号"
    type: string
  - name: return_date
    description: "退换货日期"
    type: date
  - name: doc_status
    description: "退换货状态"
    type: string
  - name: return_type
    description: "退换货业务类型"
    type: string
  - name: product_code
    description: "商品编号/货号"
    type: string
  - name: product_name
    description: "商品名称"
    type: string
  - name: size_code
    description: "尺码"
    type: string
  - name: brand_code
    description: "品牌编码"
    type: string
  - name: brand_name
    description: "品牌名称"
    type: string
  - name: category_code
    description: "品类编码"
    type: string
  - name: return_quantity
    description: "退货数量"
    type: integer
  - name: return_net_amount
    description: "实际退货金额"
    type: decimal

required_params: [store_scope, start_date, end_date]
auto_dimensions: true

capabilities:
  sales.return_analysis: true

metrics:
  return_amount:
    expr: "SUM(return_net_amount)"
    label: "退货金额"
  return_qty:
    expr: "SUM(return_quantity)"
    label: "退货数量"
  return_order_count:
    expr: "COUNT(DISTINCT return_doc_id)"
    label: "退货单数"

dimensions:
  date:
    select_exprs: ["DATE(return_date) AS return_date"]
    group_exprs: ["DATE(return_date)"]
    order_exprs: ["DATE(return_date)"]
    display_mapping: {return_date: "日期"}
    capabilities:
      sales.return_analysis: true
  product:
    select_exprs:
      - "product_code AS product_code"
      - "product_name AS product_name"
      - "MAX(brand_code) AS brand_code"
      - "MAX(brand_name) AS brand_name"
      - "MAX(category_code) AS category_code"
    group_exprs: ["product_code", "product_name"]
    display_mapping:
      product_code: "商品编码"
      product_name: "商品名称"
      brand_name: "品牌"
      category_code: "品类"
    capabilities:
      sales.return_analysis: true
这个配置回答了几个问题。用户说“退货金额”,系统知道它不是某个明细字段原样展示,而是 SUM(return_net_amount);用户说“退货数量”,系统知道它是 SUM(return_quantity);用户说“按商品”,系统知道商品维度需要同时选择商品编码和商品名称,并按这两个表达式分组;用户说“按尺码”,因为 auto_dimensions: true 且 size_code 是可分组字段,系统会自动派生 size_code AS size_code 和 GROUP BY size_code。
另一个场景也能说明 YAML 的价值。用户问:
按商品品牌信息汇总退货情况,按照金额倒排序
Query Planner 可以把“商品品牌信息”解析成 brand_name,把“金额倒排序”解析成 sort.field = 退货金额。SQL builder 最终会生成:
SELECT
    brand_name AS brand_name,
    SUM(return_net_amount) AS return_amount
FROM return_topic_cte
GROUP BY brand_name
ORDER BY return_amount DESC
这里没有为“品牌退货汇总”单独写一个工具,也没有在注册信息里维护一条“品牌金额倒序”的固定报表。YAML 只维护数据面的字段、指标和维度语义,具体报表组合由 Query Planner 和 builder 运行时完成。
第四个节点是 SQL builder。它解决的问题是“Query Planner 可以生成查询规格,但 SQL 必须由系统受控编译”。
对于主案例,builder 会先做一次语义解析:
metrics:    ["退货金额", "退货数量"] -> ["return_amount", "return_qty"]
dimensions: ["product", "size_code"] -> ["product", "size_code"]
sort:       {"field": "退货金额", "order": "desc"} -> ORDER BY return_amount DESC
limit:      20 -> LIMIT :limit
然后生成 outer SQL,也就是只运行在 return_topic_cte 之上的外层报表 SQL:
SELECT
    product_code AS product_code,
    product_name AS product_name,
    MAX(brand_code) AS brand_code,
    MAX(brand_name) AS brand_name,
    MAX(category_code) AS category_code,
    size_code AS size_code,
    SUM(return_net_amount) AS return_amount,
    SUM(return_quantity) AS return_qty
FROM return_topic_cte
GROUP BY product_code, product_name, size_code
ORDER BY return_amount DESC
LIMIT :limit
最终执行 SQL 是 CTE 模板加 outer SQL:
WITH return_topic_cte AS (
    SELECT
        h.return_doc_id,
        h.store_id,
        DATE(h.return_date) AS return_date,
        h.doc_status,
        h.return_type,
        l.product_code,
        COALESCE(NULLIF(l.product_name, ''), l.product_code) AS product_name,
        l.size_code,
        l.brand_code,
        l.brand_name,
        l.category_code,
        l.return_quantity,
        COALESCE(l.return_net_amount, l.fallback_amount, 0) AS return_net_amount
    FROM biz_return_header h
    INNER JOIN biz_return_line l ON l.return_doc_id = h.return_doc_id
    WHERE h.store_id IN :store_scope
        AND DATE(h.return_date) BETWEEN :start_date AND :end_date
        AND h.return_type = 'RETURN'
        AND h.doc_status IN ('COMPLETED', 'SHIPPED', 'CLOSED')
)
SELECT
    product_code AS product_code,
    product_name AS product_name,
    MAX(brand_code) AS brand_code,
    MAX(brand_name) AS brand_name,
    MAX(category_code) AS category_code,
    size_code AS size_code,
    SUM(return_net_amount) AS return_amount,
    SUM(return_quantity) AS return_qty
FROM return_topic_cte
GROUP BY product_code, product_name, size_code
ORDER BY return_amount DESC
LIMIT :limit
参数由服务端注入:
{
  "store_scope": ["STORE_A", "STORE_B"],
  "start_date": "2026-04-27",
  "end_date": "2026-05-03",
  "exclude_internal": true,
  "limit": 20
}
这一步有两个边界很重要。第一,模型没有机会把 store_scope 改成自己想查的门店,权限来自 PermissionContext。第二,outer SQL 会做字段白名单校验,只允许引用 CTE 输出字段、指标别名和维度别名。如果用户要求一个数据面没有暴露的字段,系统应该明确失败或生成 feedback case,而不是编译一个看似能跑但口径不明的 SQL。
第五个节点是排序语义。它解决的问题是“用户的排序表达有很多种,但落到 SQL 必须可解释”。
同样是退货分析,用户可能说:
最近一周的退货情况,按照时间倒排序
Query Planner 应该把它理解成按日期维度展示,并按时间倒序:
{
  "source": "return_topic",
  "capability": "sales.return_analysis",
  "metrics": ["退货金额", "退货数量", "退货单数"],
  "dimensions": ["date"],
  "sort": [
    {
      "field": "时间",
      "order": "desc"
    }
  ],
  "time_range": {
    "start_date": "2026-04-27",
    "end_date": "2026-05-03",
    "keyword": "最近一周",
    "days": 7
  }
}
builder 会把“时间”解析到日期维度的展示别名 return_date,输出:
SELECT
    DATE(return_date) AS return_date,
    SUM(return_net_amount) AS return_amount,
    SUM(return_quantity) AS return_qty,
    COUNT(DISTINCT return_doc_id) AS return_order_count
FROM return_topic_cte
GROUP BY DATE(return_date)
ORDER BY return_date DESC
如果用户改成“按照退货金额倒排序”,同一个排序结构会解析到指标 return_amount,SQL 就变成 ORDER BY return_amount DESC。这也是为什么排序逻辑不能散落在各个业务工具里:排序本质上是 ReportSpec 的一部分,builder 只负责把受控语义编译成 SQL。
第六个节点是多轮状态。它解决的问题是“用户不会每一轮都把所有条件说完整”。
一个常见对话是:
用户:最近一周的退货情况,按商品,尺码分组汇总退货金额和退货数量
助手:返回表格
用户:按金额倒排序
第二轮不是一个全新查询,它是对上一轮退货报表的 revision。task_state 里需要保留上一轮的 capability、source、metrics、dimensions、time_range 和结果上下文。Query Planner 在第二轮只补充排序槽位:
{
  "task_type": "revision",
  "selected_capabilities": [
    {
      "type": "tool",
      "name": "sales.return_analysis",
      "priority": 100
    }
  ],
  "slot_update": {
    "task_relation": "revision",
    "selected_capability": "sales.return_analysis",
    "status": "ready",
    "slot_updates": {
      "report_spec": {
        "source": "return_topic",
        "capability": "sales.return_analysis",
        "metrics": ["退货金额", "退货数量"],
        "dimensions": ["product", "size_code"],
        "sort": [
          {
            "field": "退货金额",
            "order": "desc"
          }
        ],
        "time_range": {
          "start_date": "2026-04-27",
          "end_date": "2026-05-03",
          "keyword": "最近一周",
          "days": 7
        }
      }
    }
  }
}
这里的关键不是“记住聊天内容”,而是保留结构化任务态。没有结构化状态,第二轮“按金额倒排序”很容易被误判成一个缺少时间范围和指标的新任务;有了任务态,Executor 可以把它合并回上一轮报表规格,再重新编译 SQL。
第七个节点是权限和 guardrails。它解决的问题是“企业数据查询不能依赖模型自觉守规矩”。
假设用户说:
帮我查 STORE_X 门店最近一周的退货金额
如果当前登录用户的 PermissionContext.store_scope 只有 ["STORE_A", "STORE_B"],执行层不能因为用户提到了 STORE_X 就扩大查询范围。服务端注入的参数仍然只能是授权范围:
{
  "store_scope": ["STORE_A", "STORE_B"],
  "start_date": "2026-04-27",
  "end_date": "2026-05-03"
}
如果系统支持门店过滤,还必须在权限范围内求交集;如果交集为空,就应该拒绝或提示无权限,而不是把用户输入的门店号直接拼进 SQL。SQL validator 还会限制只读查询、表白名单和外层字段白名单。内部日志可以记录 SQL 和参数,面向业务用户的最终回复只能展示业务结果,不能暴露 SQL、原始 JSON 或内部状态。
第八个节点是 query trace。它解决的问题是“查询执行成功,不代表质量合格”。
主案例执行后,trace 会记录这次查询的真实结构化结果。下面是一个脱敏后的 trace 形态:
{
  "trace_id": "trace_demo_001",
  "created_at": "2026-05-03T10:30:00+08:00",
  "trace_date": "2026-05-03",
  "request_id": "req_demo_001",
  "session_id": "session_001",
  "tenant_id": "t_001",
  "user_id": "u_001",
  "user_query": "最近一周的退货情况,按商品,尺码分组汇总退货金额和退货数量,按照金额倒排序",
  "capability": "sales.return_analysis",
  "source": "return_topic",
  "status": "success",
  "report_spec": {
    "source": "return_topic",
    "capability": "sales.return_analysis",
    "metrics": ["退货金额", "退货数量"],
    "dimensions": ["product", "size_code"],
    "sort": [
      {
        "field": "退货金额",
        "order": "desc"
      }
    ]
  },
  "resolved": {
    "metrics": ["return_amount", "return_qty"],
    "metric_labels": ["退货金额", "退货数量"],
    "dimensions": ["product", "size_code"],
    "sort": {
      "field": "return_amount",
      "order": "desc"
    },
    "display_columns": ["商品编码", "商品名称", "品牌", "品类", "尺码", "退货金额", "退货数量"]
  },
  "business_time_range": {
    "start_date": "2026-04-27",
    "end_date": "2026-05-03",
    "keyword": "最近一周",
    "days": 7
  },
  "row_count": 20,
  "quality_flags": [],
  "quality_status": "ok"
}
如果再次出现“用户要求两个指标但只解析出一个”“用户要求尺码分组但 resolved dimensions 里没有 size_code”“用户要求倒序但 resolved sort 是 asc”,自动质量规则会把 trace 标记为 needs_review 或 bad。
例如早期错误版本可能留下这样的 trace:
{
  "trace_id": "trace_bad_001",
  "user_query": "最近一周的退货情况,按商品,尺码分组汇总退货金额和退货数量",
  "capability": "sales.return_analysis",
  "source": "return_topic",
  "status": "success",
  "report_spec": {
    "metrics": ["退货数量"],
    "dimensions": ["product"]
  },
  "resolved": {
    "metrics": ["return_qty"],
    "metric_labels": ["退货数量"],
    "dimensions": ["product"]
  },
  "quality_flags": [
    "requested_metric_missing:return_amount",
    "requested_dimension_missing:size_code"
  ],
  "quality_status": "needs_review"
}
这个 trace 比单纯的用户抱怨更有价值,因为它能定位问题发生在哪一层:Query Planner 输出时丢了指标和维度,还是 builder 解析时丢了,或者 CTE 元数据根本没有暴露字段。
第九个节点是 feedback case。它解决的问题是“问题要能沉淀成可修复、可回归的质量样本”。
用户反馈“尺码分组丢了”后,系统可以把它绑定到上一条 trace:
{
  "case_id": "case_demo_001",
  "created_at": "2026-05-03T10:35:00+08:00",
  "case_date": "2026-05-03",
  "trace_id": "trace_bad_001",
  "source": "user_feedback",
  "category": "dimension_missing",
  "user_feedback": "尺码分组丢了,金额也没有汇总",
  "expected": {
    "metrics": ["return_amount", "return_qty"],
    "dimensions": ["product", "size_code"]
  },
  "actual": {
    "metrics": ["return_qty"],
    "dimensions": ["product"]
  },
  "quality_flags": [
    "requested_metric_missing:return_amount",
    "requested_dimension_missing:size_code"
  ],
  "status": "open",
  "fixed_commit": ""
}
后续修复时,工程动作可能是补 CTE 字段、补 YAML 维度、修 Query Planner 的结构化输出约束、修通用澄清边界、修 builder 解析,或者补状态合并。修完后把这个自然语言问题加入回归测试,case 关联修复 commit,状态改成 resolved。这样数据查询能力会形成正向循环,而不是靠聊天记录里零散的问题描述推动优化。
第十个节点是人工核对入口。它解决的问题是“质量样本要能被运营或工程人员批量查看”。
trace 和 case 都按日期切分:
data/traces/query_traces/YYYY-MM-DD.jsonl
data/feedback/feedback_cases/YYYY-MM-DD.jsonl
这里的 trace 日期是请求发生日期,不是用户查询的业务日期。自动生成的 feedback case 会跟随 trace 日期,人工提交的 feedback case 则记录提交日期并通过 trace_id 关联原始 trace。用户在 2026-05-03 问“最近一周”,trace 落到 2026-05-03.jsonl,业务时间范围保存在 business_time_range 里。这样线上排查按发生日期找日志,业务复核按 trace 里的业务日期看数据。
内部页面可以按日期、capability 和质量状态筛选:
/ops/quality/reports
命令行可以生成离线报告:
PYTHONPATH=src .venv/bin/python -m agent_os.feedback report \
  --from 2026-05-01 \
  --to 2026-05-03 \
  --capability sales.return_analysis \
  --out data/reports/quality/2026-05-01_2026-05-03
输出文件包括:
summary.md
traces.csv
feedback_cases.csv
needs_review.jsonl
这个入口的价值在于把“线上一次回答不符合预期”转成“某个日期范围内有多少 needs_review、哪些维度经常缺失、哪些 capability 问题最多、哪些 case 还没修”。Langfuse 仍然负责链路观测,例如 Agent OS Planner 调用、Data Query 插件内 Query Planner 调用、模型耗时、provider span 和异常栈;本地 trace / feedback 负责质量数据集和人工核对。一个回答“这次请求怎么跑的”,一个回答“这类业务问题是否已经沉淀、修复并回归”。
把这些节点串起来看,企业内部数据查询 Agent 的关键不在于让模型无约束地产生 SQL,而在于把自由度放在正确的位置。Data Query 插件内部的 Query Planner 负责把用户问题转换成 ReportSpec,CTE 和 YAML 负责定义受控数据面和业务语义,SQL builder 负责把查询规格编译成可审计的 SQL,权限和 guardrails 负责拦住越权和不可信查询,task_state 负责多轮合并,query trace 和 feedback case 负责持续改进。
这套方案也不会假装回答所有问题。退货率、退款率这种指标需要确认分母口径;跨域分析可能需要多个 capability 编排;写操作、审批、发券、改单需要更严格的授权和确认。真正重要的是边界清晰:用户看到的是业务结果,工程侧沉淀的是报表规格、执行 SQL、权限参数、质量 trace 和反馈 case。只有这样,企业数据查询 Agent 才能从一个自然语言查询 Demo,演进成可以长期迭代的生产能力。