文章目录
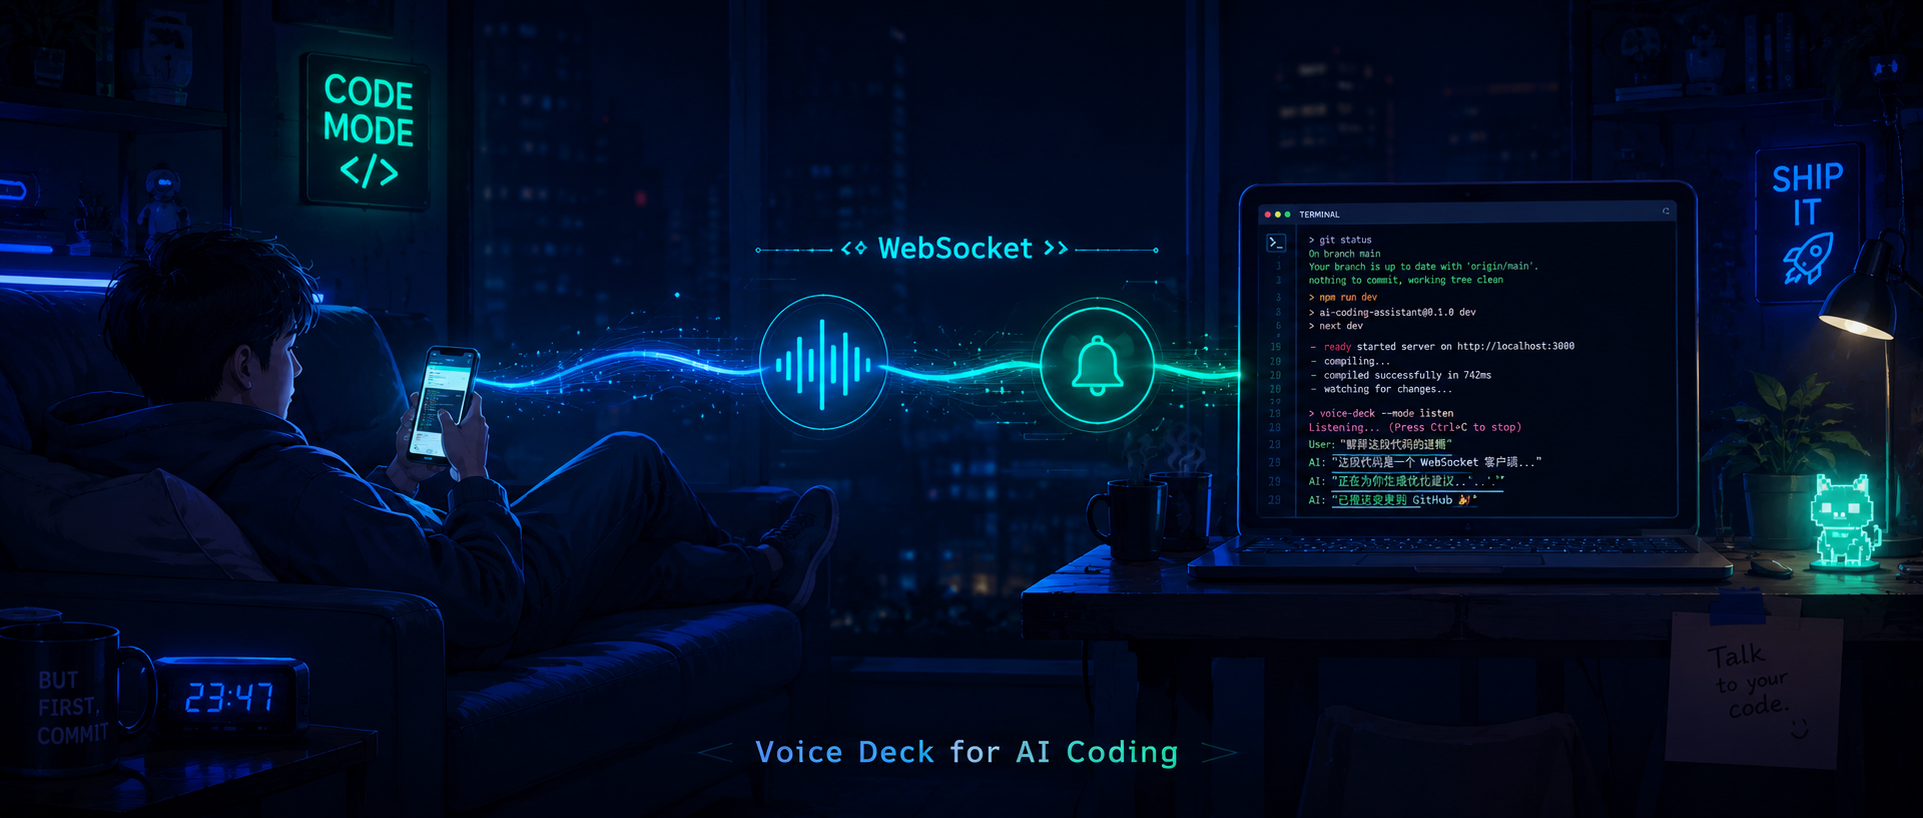
我跑了一个重构任务。Claude Code 在终端里埋头苦干,预估十分钟以上。
坐在那盯着终端看进度条?我又不是新手。起身倒了杯水,瘫到沙发上刷手机。
过了一会儿,手机震了一下。推送通知:Agent 跑完了,正在等确认。
我对着手机说:"继续,把测试也跑一下。"
听到 Whisper 一响,终端里开始跑测试。等我溜达回电脑前,测试全绿了。
这不是概念 Demo,是我现在每天在用的东西。
起因:AI 编程全是 CLI,但我不想一直坐在电脑前
今年 AI 编程工具的主力全是 CLI:Claude Code、Codex CLI、Gemini CLI、Aider、OpenCode。交互方式集体回到了终端时代。
CLI 的控制力确实强,这不是退步。但人不是一直坐在键盘前的。
跑一个长任务,你想去阳台站一会儿;Agent 问了个 yes/no 的确认,你不想为此跑回电脑;开了三个 session 在并行跑,你想在手机上扫一眼进度。这些需求很朴素,但现有工具都不管这件事。
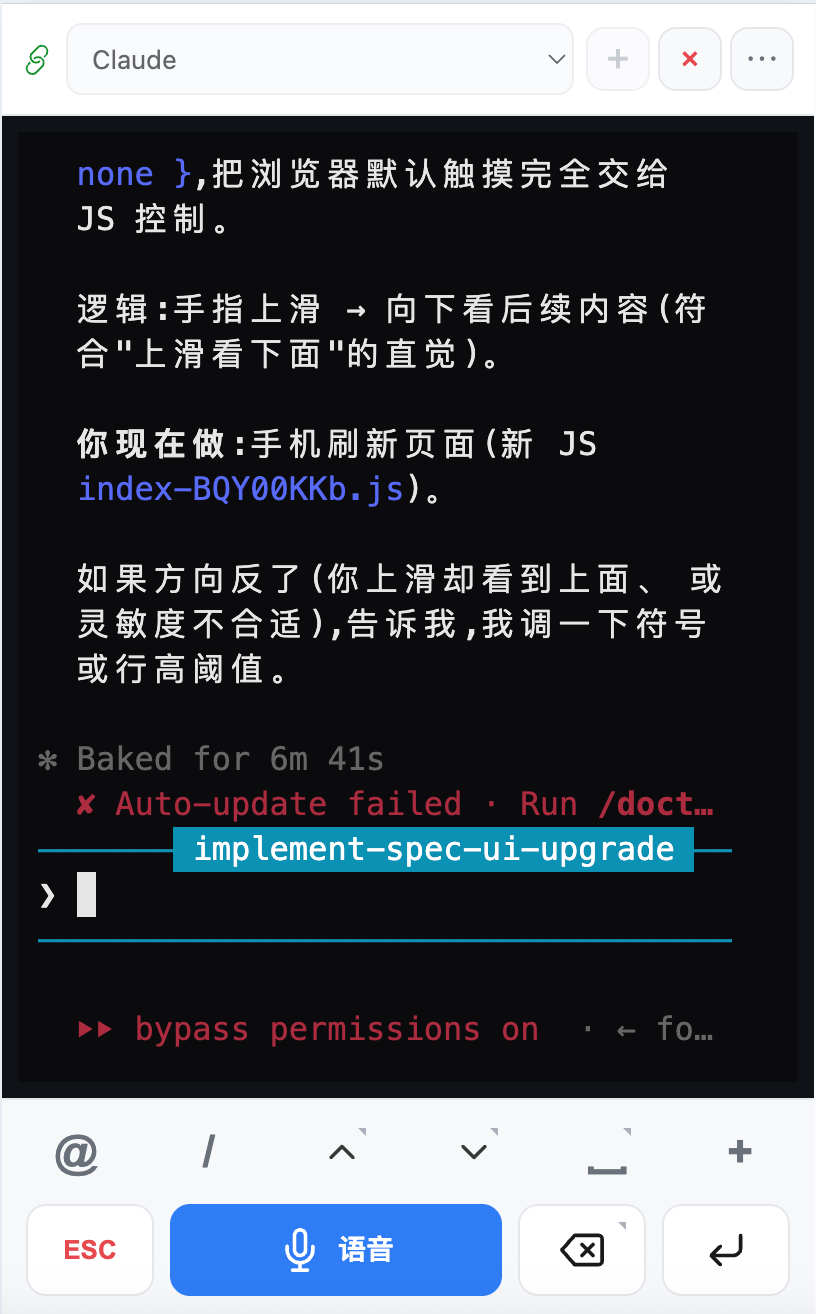
上周末心血来潮,花了两天做了一个东西:手机变成终端遥控器。
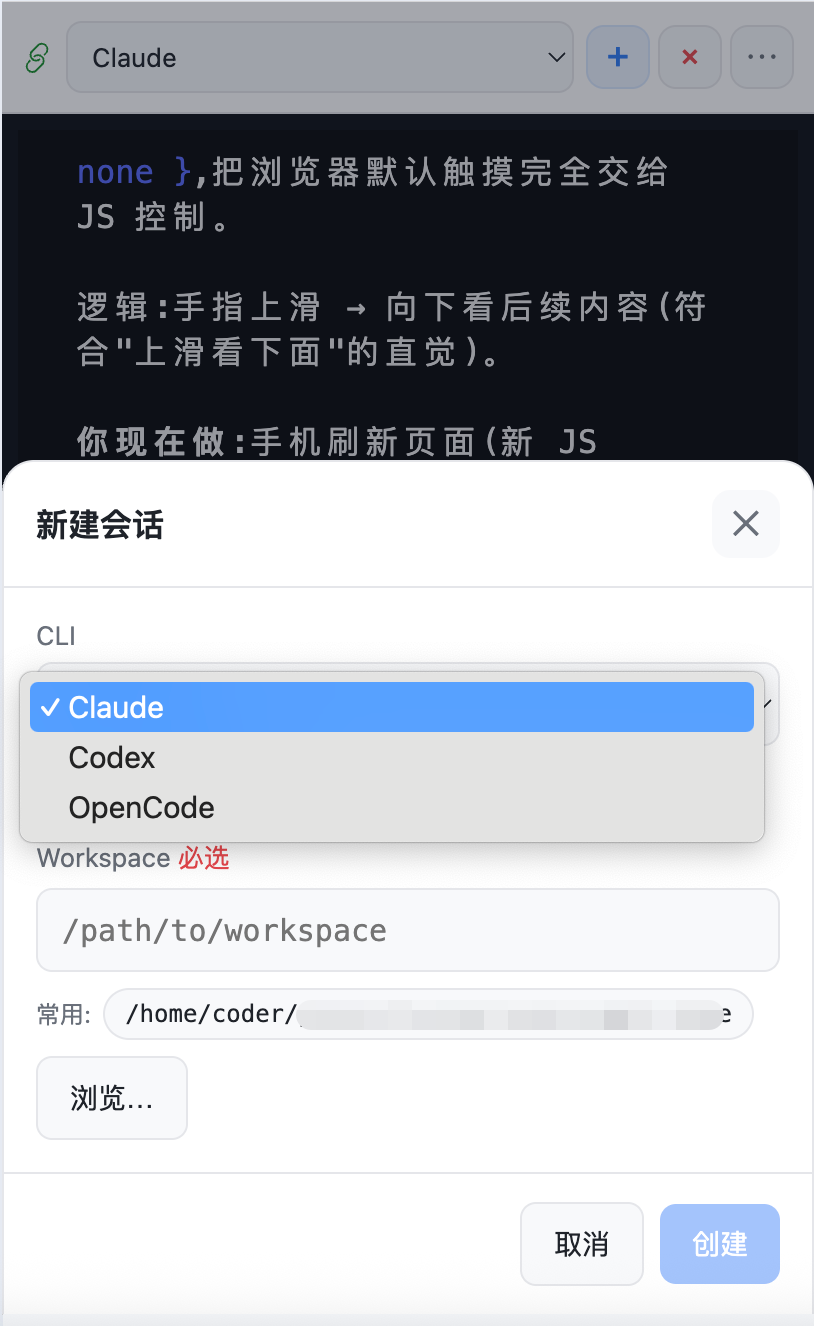
打开手机浏览器,看到电脑上 Agent 的实时输出。长按说话,语音变成指令注入终端。Agent 做完了推送通知到手机。手机锁屏了终端继续跑,重连时输出自动追上。
下面聊聊做这个东西的过程,和几个有意思的工程决策。
语音到终端:一句话变成一次按键或一段 prompt
语音遥控终端,第一反应是"语音转文字,注入终端"。但真用起来会发现,终端不只是接受文字输入的。
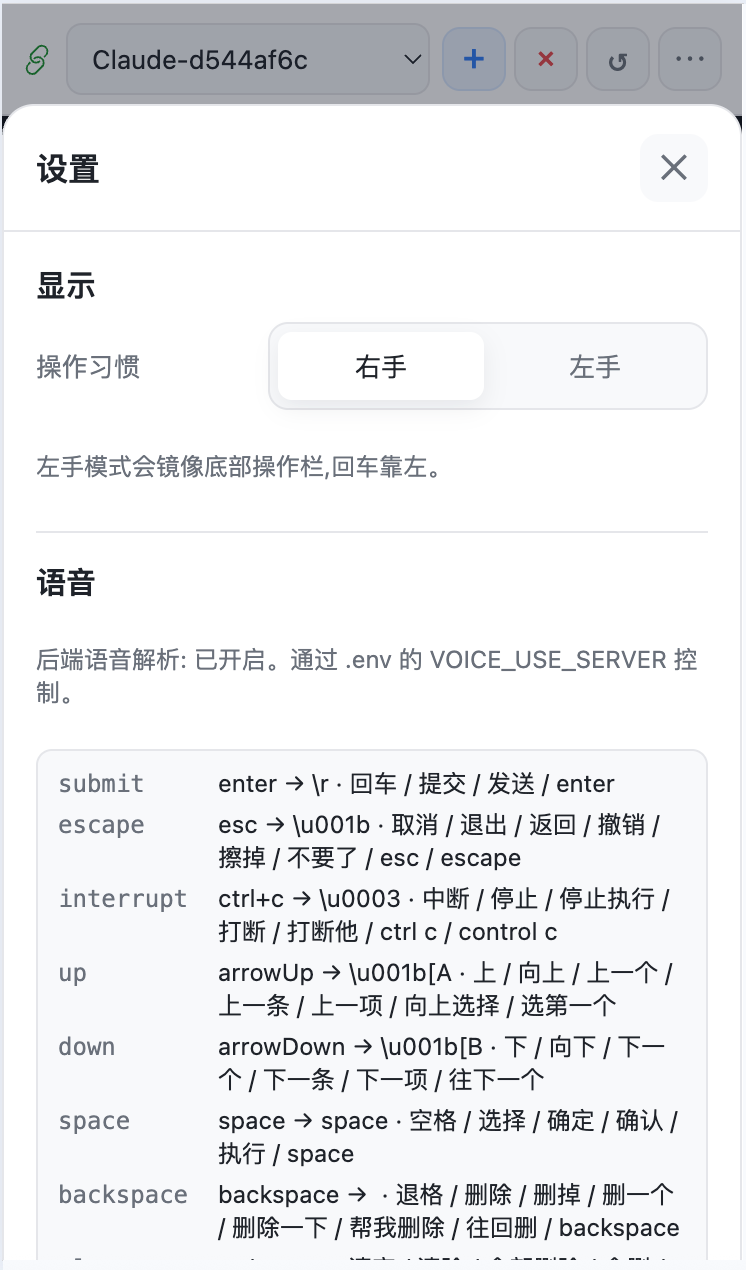
你说"回车",期望的不是在终端里打出"回车"两个字,而是按下 Enter 键。你说"中断",期望的是 Ctrl+C。你说"向上",期望的是方向键 ↑。
所以语音管道不能只是 ASR → 注入。它需要分清楚:这句话是控制命令,还是文本输入。
我做了两层:
第一层:正则快速匹配。配置了一批中文控制词:"回车"→ Enter,"中断"→ Ctrl+C,"确认"→ y + Enter,"向上""向下"→ 方向键。这一层延迟极低,说完立刻执行。
第二层:LLM 修正后注入。如果不是控制命令,就把 ASR 转写结果交给 LLM 做一次清洗。
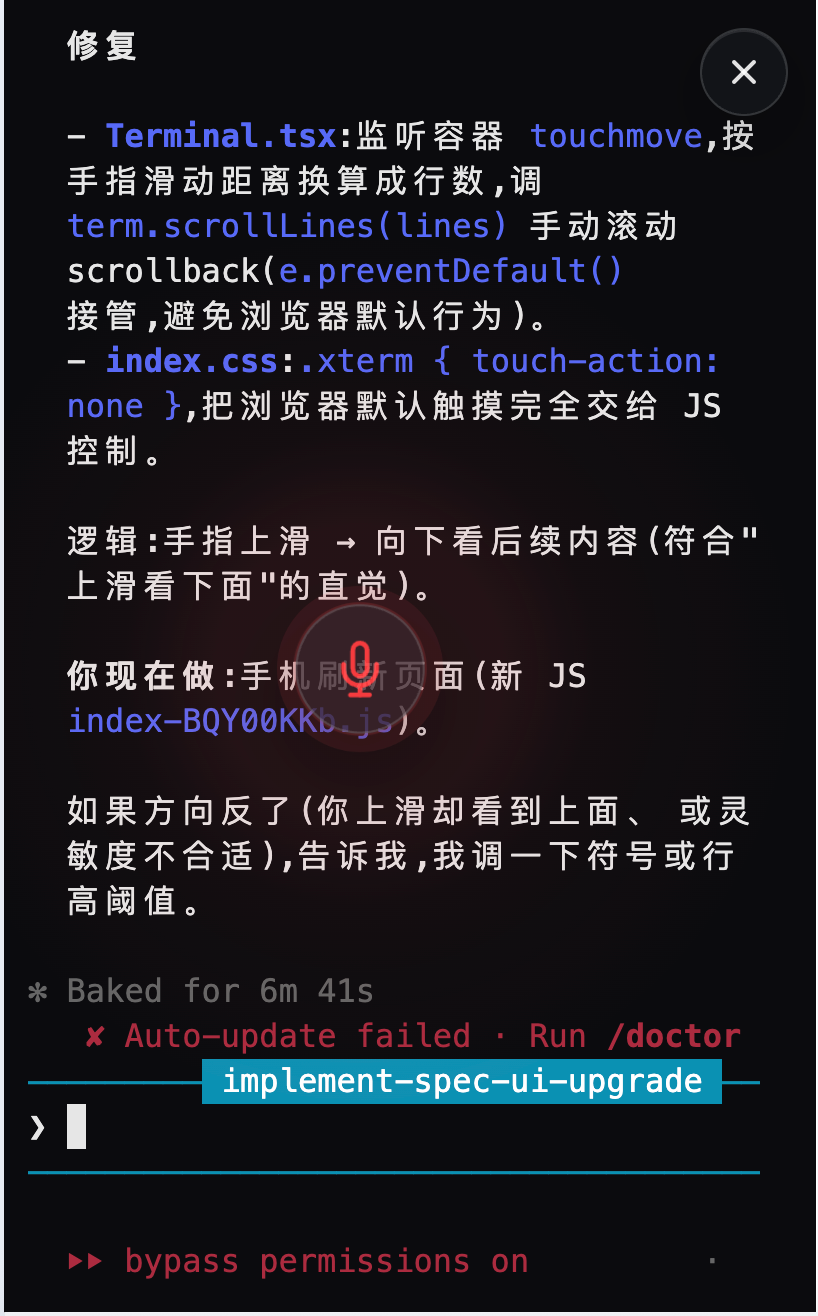
为什么需要 LLM?不是因为语音识别不准,而是因为人说话太乱。真实场景:
我说的:   "呃那个……帮我把刚才那个函数改一下,就是返回值那块,用 optional 包一下"
ASR 听到的:呃那个帮我把刚才那个函数改一下就是返回值那块用optional包一下
LLM 修正后: 把刚才那个函数的返回值用 Optional 包一下
口头禅删掉了,犹豫词去掉了,格式规范了。但意图没变。这一步的价值不是纠错,是把口语变成干净的指令。
一个细节:LLM 的 system prompt 可以让用户自己配(放在一个 markdown 文件里),但输出格式契约是硬编码在代码里的,用户配置无法覆盖。这是防止配置注入——用户 prompt 写了"请用中文回复"之类的话,不能打乱输出解析。
PTY 不跟着手机走:你不在的时候 Agent 继续干活
这是整个项目体验层面最重要的一个决策。
普通的远程终端方案,连接断了,进程可能跟着死。但我这里的场景是:手机锁屏是常态——你不可能一直盯着手机看终端。
所以架构从一开始就是:PTY 生命周期和 WebSocket 连接分离。
- 手机连上来 → attach 到已有 PTY session
- 手机断开(锁屏、切 app、网络抖动)→ PTY 继续跑
- 手机重连 → replay 之前的 scrollback buffer(默认 50KB 环形缓冲)
你离开五分钟,回来能看到这五分钟里 Agent 输出了什么。不会丢失上下文。
背后是 node-pty 起的真实伪终端进程,不是模拟的。Claude Code、Codex CLI 跑在里面和直接在 iTerm 里跑没有区别。
通知:Agent 做完了,手机震一下
长任务跑完之后,你怎么知道?
方案很简单。每个 PTY session 启动时,server 往环境变量里注入一个地址:
VENUS_NOTIFICATION_URL=http://192.168.1.10:3000/api/notification
任何跑在这个终端里的程序,都可以 curl 这个地址来发通知。
比如 Claude Code 支持 Hook 机制,你可以在 Stop hook 里加一行:
curl -s -X POST "$VENUS_NOTIFICATION_URL" \
  -H 'Content-Type: application/json' \
  -d '{"title":"Claude Code","body":"任务完成"}'
Agent 跑完 → 触发 hook → POST 通知 → server 转发 Web Push → 手机震动。
不需要装任何 SDK,不需要改 Agent 代码。环境变量 + curl,任何 CLI 工具都能用。
为什么没用 Express
整个 server 的运行时依赖只有 5 个:ws、node-pty、web-push、edge-tts-universal、dotenv。
HTTP 层是 raw node:http,路由是手写的分发器,50 行。
不是因为"想造轮子",而是这个东西跑在你自己的开发机上,LAN 内访问。路由一共十几条,不需要中间件体系、不需要模板引擎、不需要 session 管理。引入 Express 只会多出一堆你用不到的东西,以及偶尔 npm audit 报的安全告警。
开发机上跑的工具,依赖越少越安心。
真实用起来的边界
好用的场景:
- 长任务等待:Claude Code 跑个大重构,十几分钟不用守着
- 简单确认:Agent 问 yes/no,一句话搞定
- 多 session 巡视:开了三个 Agent 并行跑,手机上切着看谁先完事
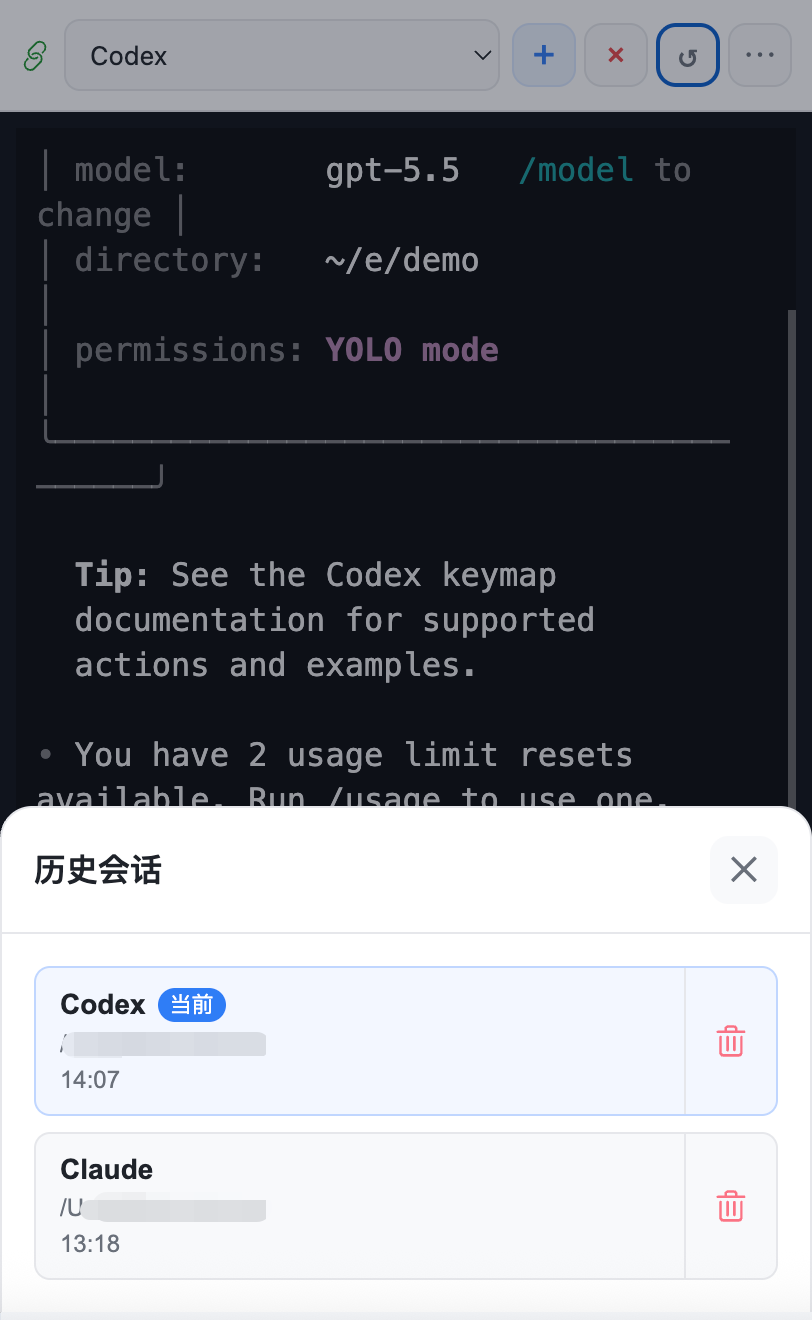 - 移动场景:公司到家的通勤路上,手机接着看 Agent 进度
不好用的场景:
- 复杂多行输入:需要写一大段 prompt 的时候,语音不如打字
- 代码片段:口述代码不现实,这时候还是得坐回电脑
- 精细操作:Vim 里移动光标、选择文本这种,语音控制不了
一句话总结边界:语音适合指令式交互,不适合创作式输入。Agent 模式下大部分交互恰好是指令式的——"继续""确认""帮我跑一下测试""切到另一个分支"——这正好是语音的舒适区。
如果你也想搞一个
技术门槛不高:
- Node.js 20+,TypeScript
- 手机和电脑在同一局域网
- ASR 用阿里 DashScope(有免费额度),也可以接本地 Whisper
- 前端是个 React SPA,手机浏览器打开就行,不需要装 App
一个周末能跑起来。对我来说最大的阻力不是编码,是想清楚"语音应该在什么粒度上和终端交互"这件事。想明白了之后,实现反而快。
结尾
AI 编程工具越来越强,跑一个任务的时间越来越长。人的角色从"写代码的"变成了"审代码的、给指令的、盯进度的"。
这些事不需要你坐在键盘前。手机、语音、推送——这些消费级设备和交互方式,反而比第二块显示器更适合这种工作节奏。
一个周末做的小东西,不复杂,但用起来确实改变了我和 Agent 相处的方式。以前是我等它,现在是它做完了来叫我。
工具的价值不在功能多,在它能不能融进你真实的工作节奏。