AI 测试的自闭环:当 AI 有了"眼睛"和"记忆"
通过 Recon、Capture 和 Coverage,让 AI 测试看见真实页面、保留反馈并修正失败。
文章目录
前两篇文章,我们聊了怎么让 AI 写测试,怎么让框架能演进。但凡动手试过的读者,都会撞上同一堵墙——AI 生成的测试,头一回跑基本全红。
这不是你的问题,也不是模型的问题。问题出在更根本的地方:AI 写测试的时候,它看不到页面。它所有的判断都来自源码分析和模板推断,本质上是在"盲写"。
这篇文章,我们就来解决这件事。怎么让 AI 从"盲写"变成"看得见、记得住、能自愈"的测试智能体。
一、AI 生成的测试,为什么第一次跑不通?
先别急着怀疑模型能力。我们先看看真实场景里,AI 生成的测试到底是怎么死的。
1.1 场景还原
你按照前两篇的方法搭好了框架,Agent 也确实生成了看起来很规范的测试套件——选择器有、断言有、步骤清晰。你满怀期待地按下回车,然后:
waiting for get_by_role("button", name: "提交") — timed out
element is not visible
Error: locator.resolve: failed to find element
满屏飘红。不是段子,这是每个用 AI 生成 E2E 测试的人都会经历的真实日常。
1.2 五种典型死法
我总结了 AI 生成测试最常见的五种失败模式,你大概率都见过:
死法一:选择器不存在
AI 从源码推断按钮叫"提交",但页面上实际渲染出来的是"保存"。
// AI 生成的
await page.getByRole('button', { name: '提交' }).click();
// 报错:waiting for get_by_role("button", name: "提交") — timed out
这种情况特别常见于中后台系统——后端的字段名、前端的 label、UI 上实际展示的文字,三者经常不一致。AI 只看了源码,没看页面,自然猜不对。
死法二:时序问题
AI 写了导航之后立刻读取表单值,但 SPA 还在异步加载组件,DOM 节点都还没渲染出来。
await page.goto(baseUrl + routes.publish);
const name = await page.getByPlaceholder('技能名称').inputValue();
// 报错:element is not visible — 组件还没渲染完
这种问题在老项目里尤其突出——组件懒加载、接口请求、路由守卫,哪个不是异步的?AI 不知道页面需要等多久,它只看到了源码里"有这个字段"。
死法三:路由猜错
AI 从配置文件推断路由是 /skills/publish,结果实际路径是 /skills/create。这种问题不复杂,但排查起来很烦人——因为报错信息往往是"页面找不到某个元素",你不会第一时间想到是路由错了。
死法四:跨步骤数据依赖
step B 需要用到技能名称,但这个值是 step A 在运行时动态填写的——AI 用静态的 YAML 测试数据根本覆盖不了这种动态场景。
举个例子:step A 创建了一个叫"测试技能V3"的技能,step B 要验证列表里是否出现了这个名字。AI 怎么知道 step A 到底填了什么?它写脚本的时候,step A 的执行结果还不存在。
死法五:状态污染
上一个 spec 修改了页面状态(比如切换了某个 Tab、展开了某个面板),当前 spec 却假设页面处于初始状态,导致定位失败。这种问题最恶心——单独跑每个 spec 都过,一起跑就挂,排查成本极高。
1.3 核心矛盾
看完这五种死法,你应该已经发现了一个共同点:
AI 写测试的时候,它看不到真实页面。
它所有的判断都来自源码分析和模板推断。它知道组件源码里有 <Button>提交</Button>,但它不知道这个组件在运行时会被哪个 HOC 包一层、被哪个条件分支改了文案、被哪个接口返回值控制了显隐。
这不是 Prompt 不够好的问题,不是模型不够强的问题,而是信息不对称——AI 缺乏对真实运行环境的感知。你给一个从来没见过页面的工程师提需求,让他盲写测试,他也写不对。
二、破局思路:让 AI "先观察,再行动"
2.1 优秀测试工程师是怎么工作的
想明白怎么让 AI 写好测试,不如先看看优秀的测试工程师是怎么工作的:
普通开发写测试:  看需求文档 -> 写断言 -> 交给 CI -> 红了再改
优秀测试工程师:  先打开页面 -> 看结构 -> 设计用例 -> 执行 -> 观察结果 -> 调整
关键区别在哪?优秀工程师在写用例之前,会先花时间"看"页面——看有多少个区块、哪些字段是必填的、按钮叫什么名字、操作之间有没有先后依赖。
AI 之前走的是第一条路——直接从源码"盲写"。我们要让它走第二条路:先观察,再行动。
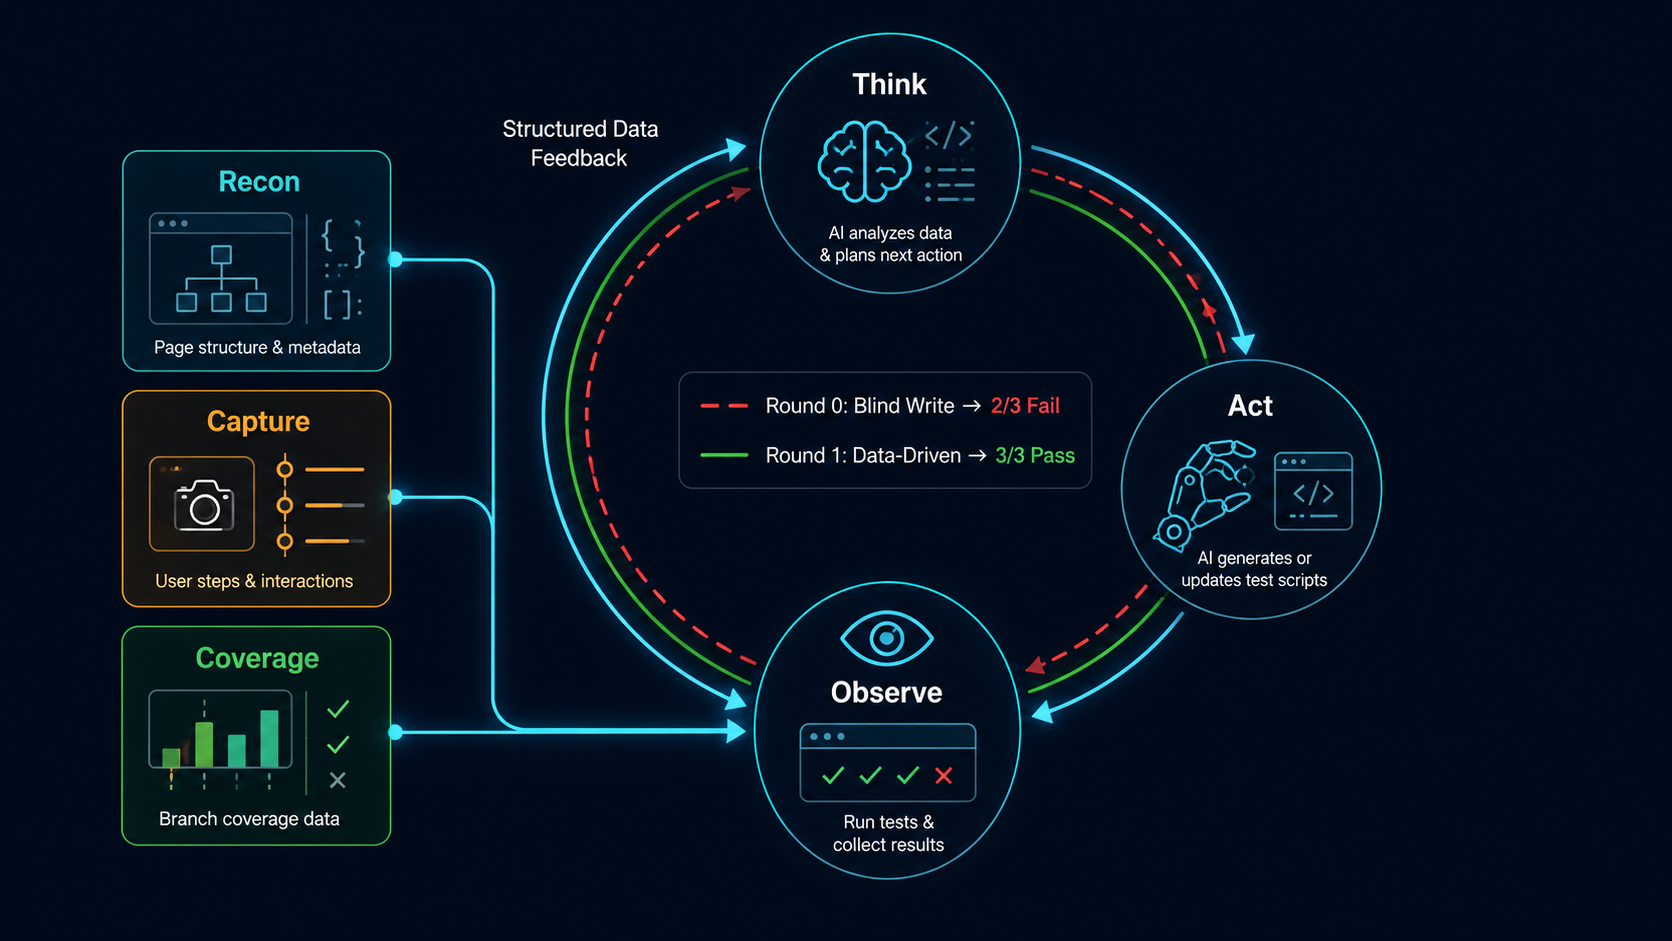
2.2 引入 ReAct 模式
ReAct(Reasoning + Acting) 是 AI Agent 领域的一种经典模式,核心思想是让 AI 交替进行"推理"和"行动":
Think(分析源码)
  -> Act(侦察真实页面)
  -> Observe(观察实际结果)
  -> Think(基于事实调整策略)
  -> Act(生成/修改测试)
  -> Observe(运行验证)
  -> ... 直到通过
但这里有一个关键的认知误区要澄清:ReAct 不是 Prompt 层面的技巧。你不可能靠一句"请仔细思考后再写测试"就让 AI 写对。AI 需要真实数据来驱动推理,而这些数据必须由框架主动采集、结构化输出。
所以我们要做的,是在框架层面给 AI 装上三样东西:Recon(侦察)、Capture(捕获)、Coverage(覆盖率)。三者各司其职,共同支撑 ReAct 闭环。
三、Recon:让 AI "看到"真实页面
3.1 设计哲学
Recon 这个名字来自"侦察"(Reconnaissance)。核心思路很简单:在写一行测试代码之前,先花 30 秒"看"一眼真实页面。
输入:workspace + 模块名
流程:启动浏览器 -> 登录 -> 导航到目标页面 -> 捕获页面全貌 -> 输出 recon.json
整个流程自动完成,不需要人工干预。采集完成后输出一份结构化的 recon.json,AI 读到这份文件,就相当于"看到了页面"。
3.2 四层数据采集
Recon 不是简单地截个图或者 dump 一下 DOM。它采集四层数据,每一层都服务于 AI 的不同推理需求:
| 层级 | 采集内容 | AI 怎么用 |
|---|---|---|
| 选择器探针 | 每个 spec 中用到的选择器是否存在、匹配了几个元素 | 验证 AI 推断的选择器是否靠谱,直接过滤掉不存在的选择器 |
| 页面结构 | headings / buttons / inputs 及其可见性 | 理解页面的 UI 骨架,知道有哪些可交互元素 |
| 无障碍树 | 完整的 ARIA 语义结构 | 获取 Playwright 可用的 role/name 信息,精准定位元素 |
| 语义地图 | 区块 -> 字段 -> 必填/选填 -> 操作按钮 -> 表格结构 | 理解业务层面的页面组成,知道操作流程和依赖关系 |
前两层是基础能力,解决"页面上有什么"的问题。第三层无障碍树是 Playwright 的最佳实践——通过 role 和 name 定位元素,比通过 CSS 选择器稳定得多。第四层语义地图是整个 Recon 的核心发明。
3.3 语义地图:比截图更重要的东西
很多测试框架提供"失败时截图"。截图对人有用来调试,但对 AI 几乎没用——AI 需要结构化、可推理的数据,不是像素。
Recon 的核心输出是语义地图(Semantic Map)。它不是 DOM 快照,而是业务语义层面的结构化描述:
{
  "regions": [
    {
      "name": "基本信息",
      "order": 1,
      "fields": [
        { "label": "技能名称", "required": true, "type": "input", "placeholder": "请输入技能名称" },
        { "label": "技能分类", "required": true, "type": "select", "role": "combobox" },
        { "label": "技能描述", "required": false, "type": "textarea" }
      ],
      "actions": []
    },
    {
      "name": "版本管理",
      "order": 2,
      "dynamic": true,
      "fields": [],
      "actions": [{ "label": "添加版本", "role": "button" }]
    }
  ],
  "formSummary": {
    "requiredFields": [
      { "label": "技能名称", "region": "基本信息", "type": "input" },
      { "label": "技能分类", "region": "基本信息", "type": "select" }
    ],
    "actionButtons": [
      { "label": "提交审核", "role": "button" },
      { "label": "保存草稿", "role": "button" }
    ]
  },
  "flowHints": {
    "sectionOrder": ["基本信息", "版本管理", "审核信息"],
    "submitActions": ["提交审核", "保存草稿"],
    "dynamicSections": ["版本管理"]
  }
}
你看,这份语义地图告诉 AI 的信息量有多大:哪些字段是必填的、区块的操作顺序是什么、提交按钮到底叫"提交"还是"提交审核"、哪些区块是动态加载的。全部是事实,不是推断。
AI 读到这个数据,就不再需要猜了。按钮叫什么、字段是什么类型、区块之间有没有先后依赖——白纸黑字写在 recon.json 里。
3.4 自动探针生成
这里有一个工程细节值得单独说。有些模块可能没有手动定义 recon 探针,怎么办?框架会从已有的 spec 代码中自动提取选择器生成探针:
// 从 spec 源码中扫描
getByText('xxx')        -> 生成 text 探针
getByRole('button', ...)  -> 生成 button 探针
getByPlaceholder('xxx') -> 生成 placeholder 探针
这个设计背后的逻辑是:已有的测试代码本身就是选择器的天然来源——你写过的选择器,都会被验证是否仍然有效。这让 Recon 对存量项目也能零成本接入。不需要额外维护探针配置,存量测试代码就是最好的探针来源。
四、Capture:让 AI "记住"每一步发生了什么
4.1 从 "Pass/Fail" 到 "执行时间线"
有了 Recon,AI 在写测试之前就能"看到"页面了。但还有一个问题:测试跑起来之后呢?
普通测试框架只告诉你 step 通过或失败。AI 拿到一个 false,根本无法判断是选择器错了、页面没加载完、还是业务逻辑变了。就像你只告诉一个工程师"测试挂了",却不给他日志、不给截图、不给任何上下文——他也没法修。
Capture(捕获模式) 要做的就是改变这件事。它在每个 step 执行后自动记录上下文:
普通测试:  step -> boolean(通过/失败)
Capture:  step -> URL 是否变化 -> 语义快照 -> 完整的执行轨迹
4.2 智能捕获策略
当然,不可能每个 step 都做完整快照——那样执行时间会膨胀 10 倍。Capture 采用的是按需捕获的策略:
| 场景 | 捕获策略 | 原因 |
|---|---|---|
| URL 变化(页面跳转) | 完整语义地图 | 跳到了新页面,需要全面采集页面结构 |
| Step 成功 | 轻量记录(URL + 标题) | 只需要确认状态,不需要全量快照 |
| Step 失败 | 强制完整捕获 | 这是 AI 最需要的数据——失败时的完整上下文 |
重点在第三条:step 失败时的强制完整捕获。这就像一个有经验的工程师排查问题时的本能反应——报错了,先把现场保留下来。页面当前长什么样、URL 是什么、哪些元素存在、哪些不存在,全部记录。
4.3 零侵入设计
Capture 还有一个重要的设计原则:测试脚本不需要任何改动。
所有捕获逻辑都在框架的 spec-lifecycle.js 中实现,通过生命周期钩子自动注入:
// 你的 spec 代码完全不变,该怎么写还怎么写
await step('navigate', async () => {
  await page.goto(baseUrl + routes.publish);
});

// 框架自动在 step 成功/失败后追加 capture 逻辑
// URL 变了?完整快照
// step 失败?强制完整捕获
// 其他情况?轻量记录
这意味着,已有的测试脚本自动获得 Capture 能力,零迁移成本。你昨天写的测试,今天就能享受 Capture 的红利,不需要改一个字。
五、Coverage:让 AI "看到"代码盲区
Recon 让 AI 看到了页面长什么样,Capture 让 AI 看到了每一步执行时发生了什么——但还有一个关键问题:测试到底覆盖了多少业务代码?
覆盖率这件事,说起来简单做起来难。传统 E2E 覆盖率采集需要插桩(Istanbul)、需要构建工具配合、需要 CI 集成——配置重、改造量大、前端项目接入成本高。我见过不少团队,评估了一圈最后直接放弃了。
5.1 换一种更轻量的思路
我们用了一种更轻量的方式:V8 原生覆盖率。不需要改构建配置,不需要插桩,浏览器原生就支持。
一行命令就行:
venus-test-cli coverage https://portal.example.com/home --domain "*.example.com"
整个流程分三步:
- 启动浏览器——复用已有的 Playwright 配置,Chrome 路径、Profile、Viewport 全部自动继承,不需要额外配置
- 自由操作——你正常点菜单、填表单、切页面,框架在底层静默采集 V8 原生覆盖率,对你完全透明
- 按 Enter 结束——关闭浏览器,自动生成源码级可视化报告
为什么不用 Istanbul 插桩?对比一下就清楚了:
| Istanbul 插桩 | V8 原生覆盖率 | |
|---|---|---|
| 前置条件 | 需要修改构建配置、引入 babel/webpack 插件 | 浏览器原生支持,零改造 |
| 精度 | 语句/分支/函数三级,但依赖插桩质量 | 字节级精度,V8 引擎直接输出 |
| Source Map | 构建时生成 | 运行时读取,自动回射到原始源码 |
| 接入成本 | 每个项目都要改构建配置 | 一行命令,任何项目即时可用 |
| 对测试的影响 | 插桩代码可能影响行为 | 零侵入 |
说实话,我当初也犹豫过要不要用 Istanbul。毕竟它生态成熟、社区用得多。但一想到要让每个业务项目都改构建配置,还要跟 webpack 版本、babel 版本、各种 loader 打架——算了,V8 原生的不香吗?
5.2 域名过滤:解决采集噪音
还有一个实际问题需要解决。SPA 页面通常加载了几十个第三方脚本——jQuery、EasyUI、Polyfill、统计 SDK,什么都往里塞。这些脚本不需要纳入覆盖率,否则报告里全是噪音。
--domain 参数就是干这个的——只采集你指定域名下的业务脚本:
# 只看自己域名的覆盖率
venus-test-cli coverage https://portal.example.com/home \
  --domain "*.example.com"

# 多个域名也支持
venus-test-cli coverage https://portal.example.com/home \
  --domain "api.example.com,cdn.example.com"
默认还会排除 *.min.js、*.html、node_modules、vendor、jquery、easyui 这些常见的第三方库。报告里只出现你的业务代码,清清爽爽。
5.3 在 ReAct 闭环中的角色
Coverage 不只是一个"看看覆盖率"的工具。在 ReAct 闭环中,它承担了一个关键角色——告诉 AI 哪些路径还没测到。
举个例子:
AI 读 Coverage 报告
  -> 发现 bill-create.js 的 saveDraft() 函数覆盖率为 0
  -> 分析:这是一个未覆盖的业务分支
  -> 生成补充用例:覆盖"保存草稿"流程
  -> 重跑验证 -> 覆盖率提升
Recon 让 AI 看到页面,Capture 让 AI 看到执行过程,Coverage 让 AI 看到代码盲区——三者组合在一起,AI 的"视野"从 UI 层延伸到了代码层,形成了完整的感知闭环。
六、闭环实战:一个技能发布页面的自愈过程
前面讲了 Recon、Capture、Coverage 三个能力的设计思路,听起来都挺好。但技术方案好不好,得上手跑跑才知道。我们来走一遍真实案例。
6.1 初始状态
AI 根据源码生成了测试脚本,覆盖技能发布页面的 3 个核心流程。首次运行:3 个 spec,2 个失败。
6.2 失败 1:选择器不匹配
Spec: skills-publish-form-flow
Step: "填写技能名称"
错误: getByPlaceholder('请输入技能名称') -- 0 matches
AI 推断 placeholder 是"请输入技能名称",但实际页面上 placeholder 是"请输入技能名称(必填)"。差了三个字,选择器就匹配不到了。
AI 读 Capture 数据:
{
  "step": "填写技能名称",
  "url": "/skills/create",
  "urlChanged": true,
  "semanticMap": {
    "regions": [{
      "name": "基本信息",
      "fields": [
        { "label": "技能名称", "placeholder": "请输入技能名称(必填)" }
      ]
    }]
  }
}
AI 推理: Capture 数据清楚地显示,placeholder 不是"请输入技能名称",而是"请输入技能名称(必填)"。事实摆在面前,不需要猜。
修复动作: 更新 placeholder 值 -> 重跑 -> 通过。
6.3 失败 2:动态区块未激活
Spec: skills-publish-version-flow
Step: "点击添加版本按钮"
错误: getByRole('button', { name: '添加版本' }) -- 0 matches
"添加版本"按钮找不到。不是按钮不存在,而是它所在的"版本管理"区块是动态渲染的——需要先填写完基本信息,这个区块才会激活。
AI 读 Capture 数据:
{
  "step": "点击添加版本按钮",
  "semanticMap": {
    "regions": [
      { "name": "基本信息", "fields": [...], "dynamic": false },
      { "name": "版本管理", "dynamic": true, "actions": [] }
    ]
  }
}
AI 推理过程:
- "版本管理"区块标记为
dynamic: true——内容是动态渲染的 - 按钮匹配 0 个——当前状态下按钮不可见
flowHints显示操作顺序:基本信息在前,版本管理在后- 合理推断:需要先完成基本信息的填写,版本管理区块才会被激活
修复动作: 在点击"添加版本"前,增加填写基本信息的 steps -> 重跑 -> 通过。
6.4 从全红到全绿
轮次 0(盲写):           3 spec,2 失败
轮次 1(Capture 驱动修复):3 spec,全部通过
就一轮。AI 自己读 Capture 数据、自己分析根因、自己修改脚本、自己验证结果。从全红到全绿,全程不需要人工介入。
当然,不是所有场景都这么顺利。更复杂的业务流程可能需要两到三轮迭代。但关键是:每一轮迭代都有事实数据驱动,而不是人在那里反复试错。
七、设计背后的思考
7.1 结构化数据远比截图有用
这一点值得反复强调。很多测试框架提供"失败时截图",截图对人有用,对 AI 几乎没用。AI 没法从一张截图里判断"这个按钮到底叫什么名字"、"这个字段是不是必填的"。
Recon 输出的 recon.json 是机器可读的结构化数据,每一项都能被 AI 直接用于推理:
| 数据类型 | 截图 | recon.json |
|---|---|---|
| 元素是否存在 | 需要人眼识别 | matches: 3,精确到数量 |
| 字段是否必填 | 看不到 | required: true,白纸黑字 |
| 组件类型 | 需要经验判断 | role: "combobox",语义明确 |
| 区块顺序 | 需要人工扫描 | sectionOrder: [...],已排好序 |
给 AI 结构化数据,比给它一万字的自然语言描述有效得多。 这不是经验之谈,这是信息论的基本原理——噪声越少,信号越清晰,推理越准确。
7.2 观测不等于侵入
Capture 的实现遵循一个设计原则:采集不影响行为。
具体来说有三条约束:
- 捕获失败不影响测试执行——所有捕获逻辑都有 try/catch 包裹,捕获本身出了问题不会拖垮测试
- 快照策略按需触发——不是每步全量快照,而是根据场景智能选择采集粒度
- 输出到独立文件——捕获数据写到
recon.json等独立文件,不污染测试报告
这三条约束让 Capture 可以默认开启。它不是一种需要手动启用的调试模式,而是一种常态化的观测基础设施。开着它不会拖慢你,关了它你会丢失关键信息。
7.3 从工具到智能体
把 Recon、Capture、Coverage 放在一起看,你会发现它们本质上是给 AI Agent 提供了四个关键能力:
| 能力 | 人类类比 | 实现机制 |
|---|---|---|
| Recon(事先感知) | 工程师先打开页面看看再写用例 | 结构化页面侦察 -> recon.json |
| Capture(事中观测) | 工程师边跑用例边观察页面反应 | 步骤级快照 -> stepSnapshots |
| Coverage(代码视野) | 工程师看覆盖率报告找盲区 | Istanbul 插桩 -> 分支级覆盖率报告 |
| ReAct(事后推理) | 工程师分析失败原因并修改用例 | AI 读 capture/coverage -> 分析根因 -> 修改脚本 |
四个能力各司其职,但组合起来才形成了质变。单独的 Recon 只是一份侦察报告,单独的 Capture 只是一份执行日志——但当 AI 能同时拥有两者,并基于事实数据进行推理和行动时,它就从"一次性生成器"升级为了可以自我进化的测试智能体。
八、效果与展望
8.1 量化效果
数据说话,这是我们跑了多个模块之后统计出来的:
| 指标 | 无 Recon/Capture | 有 Recon/Capture/Coverage |
|---|---|---|
| AI 生成用例首次通过率 | ~30% | ~75% |
| 人工调试时间 | 30-60 分钟/模块 | 5-10 分钟/模块 |
| 迭代到全绿所需轮次 | 3-5 轮 | 1-2 轮 |
| 选择器相关失败占比 | ~40% | < 5% |
| 覆盖率盲区发现 | 靠人工 Code Review | Coverage 报告自动定位 |
首次通过率从 30% 提到 75%,这个数字不是理论推算,是实打实跑出来的。选择器相关失败占比从 40% 降到 5% 以下,基本解决了"AI 猜不对选择器"这个老大难问题。
8.2 对团队的价值
- 测试工程师:从"调试 AI 生成的坏脚本"变成"审核 AI 基于真实数据生成的好脚本"。工作性质从"修修补补"变成了"把关审核",体验完全不同。
- 开发工程师:提交代码后快速跑一轮 Recon,验证页面结构是否符合预期。相当于有了一个自动化的 UI 回归哨兵。
- AI 本身:随着 Recon 数据的积累,跨模块的模式识别越来越精准。一个模块踩过的坑,AI 在生成其他模块测试时会主动规避。
8.3 Coverage:Istanbul 插桩驱动的精准覆盖率
Recon 告诉 AI 页面长什么样,Capture 告诉 AI 每一步发生了什么——但还有一个问题:测试到底覆盖了多少业务代码? 覆盖率是 AI 精准优化测试的最后一公里。不知道哪些代码没被测到,AI 就只能"凭感觉"补充用例。
浏览器自带 V8 覆盖率采集,看起来零成本——但精度不够,特别是原生 JavaScript。V8 只知道某个字节范围被执行过,无法区分逻辑分支。对于 eval、动态脚本,统计还会出现偏差。AI 优化测试需要的是分支级精度——不仅要知道哪个函数没调到,还要知道 if/else 走了哪条路。
| V8 原生覆盖率 | Istanbul 插桩 | |
|---|---|---|
| 精度 | 字节级,无法区分逻辑分支 | 行/函数/分支三级精度 |
| 原生 JS | ❌ 不准确,动态脚本覆盖偏大 | ✅ 精确追踪每个语句、每个分支 |
| 分支覆盖 | ❌ 无(只知"执行过") | ✅ if/else、switch、三元表达式逐分支统计 |
| AI 可用性 | "这个文件覆盖了 60%" | "saveDraft() 的 else 分支(第 47 行)覆盖 0 次" |
所以 Venus 选择了 Istanbul 插桩方案:
- SPA 项目:
vite-plugin-istanbul构建时注入探针,测试运行时从window.__coverage__采集数据 - EUI(EasyUI)项目:
nyc instrument --complete-copy --produce-source-map离线注入 - 采集到的 Istanbul 数据通过
monocart-coverage-reports生成源码级 HTML 报告,自动映射回 TypeScript 原始源码
# 测试执行时开启覆盖率
venus-test-cli run ./workspace --coverage --suite mcp
对 ReAct 闭环的价值——告诉 AI 哪些路径还没测到:
AI 读 Istanbul 覆盖率报告
  → 发现 bill-create.js 的 saveDraft() 函数覆盖率为 0
  → 分支覆盖显示:异常处理分支(第 47 行 else)从未触发
  → 分析:这是一个未覆盖的业务分支
  → 生成补充用例:覆盖"保存草稿" + "草稿名称重复"两个场景
  → 重跑验证 → 覆盖率提升
Recon 让 AI 看到页面,Capture 让 AI 看到执行过程,Coverage 让 AI 看到代码盲区。而 Istanbul 的分支级精度,让 AI 的优化不再是"差不多覆盖了",而是"每个分支都走到了"。
8.4 下一步探索
Recon -> Capture -> Coverage -> ReAct 闭环的建立,意味着 AI 测试从"生成工具"进化为"测试智能体"。但这件事还没有到终点,还有几个方向值得继续深挖:
- 增量 Recon:代码变更时只侦察受影响的模块,而不是全量跑一遍。对于大型项目来说,这能大幅加速反馈速度。
- Recon Diff:对比两次侦察结果,自动发现页面结构变更。相当于给页面做了一次 diff——新增了哪些字段、删除了哪些按钮、区块顺序有没有变化,一目了然。
- 覆盖率驱动用例生成:AI 读 Coverage 盲区 -> 自动生成补充用例 -> 再次采集 -> 迭代至目标覆盖率。这是 ReAct 闭环的终极形态——AI 不只是修复失败的用例,还能主动发现未覆盖的场景。
写在最后
第一篇,我们回答了"怎么让 AI 写测试"——SDD + AI + CDP,从零到一搭起来。
第二篇,我们回答了"怎么让测试框架能演进"——架构重构 + 远程 Chrome,让框架跟上业务的变化。
这一篇,我们回答了最难的问题:怎么让 AI 写的测试真的能用?
答案不是更好的 Prompt,不是更强的模型,而是给 AI 真实的数据反馈。
当 AI 能"看到"真实页面(Recon)、"记住"执行过程(Capture)、"发现"代码盲区(Coverage)、"推理"失败原因(ReAct),它就不再是一个"生成器"了,而是一个可以自我进化的测试伙伴。
E2E 测试的终极形态,或许不是人类写出更完美的测试用例,而是 AI 在真实环境中持续观察、持续学习、持续优化——把我们从"最后一公里"的泥潭里解放出来,去做更有价值的事。
本文基于 venus-sdd-auto-test 项目的真实演进实践。Recon 采集四层数据(探针 + 页面结构 + 无障碍树 + 语义地图),Capture 实现步骤级智能快照,Coverage 基于 Istanbul 插桩提供分支级覆盖率(行/函数/分支精度、source map 自动回射),ReAct 闭环已在 venus-ai-market-test 项目中验证通过。框架代码约 6000 行,支持 EUI 和 SPA 双模式。