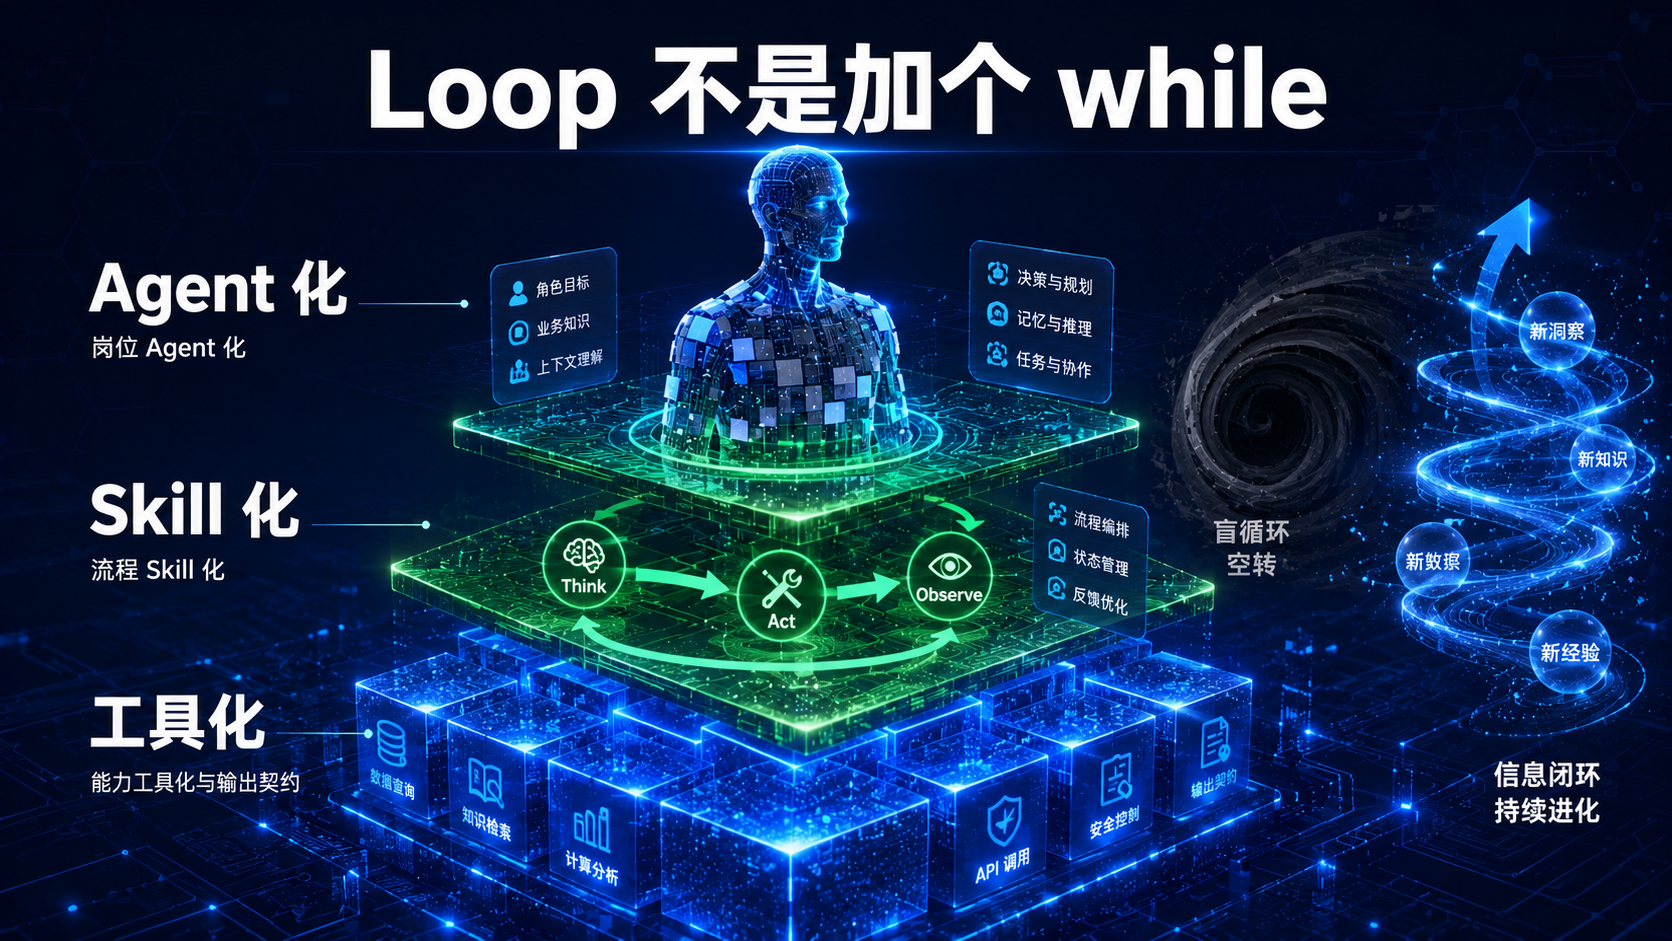
Loop 不是加个 while:能力工具化、流程 Skill 化、岗位 Agent 化
循环能不能收敛,取决于新的事实、工具契约和流程骨架能不能进入下一轮。
文章目录
AI 圈最近都在谈 loop。Agentic Loop、ReAct Loop、Self-healing Loop——概念一个比一个响。但动手试过的人都知道,大多数 loop 跑不通。不是模型不够强,是 loop 底下缺了三层东西:工具化的能力、Skill 化的流程、Agent 化的岗位。
上篇文章我们用 Recon/Capture/Coverage 让 AI 从"盲写测试"变成了"看得见、记得住、能自愈"的测试智能体。这篇文章,我想把那个实践抽象出来——loop 能跑通,不是因为你在代码里加了个 while,而是因为你先做了三件事。
一、Loop 的热潮与误区
最近,AI 圈大佬都在谈 loop。
从 OpenAI 的 Agentic Loop 到 Anthropic 的 ReAct 模式,从各种"self-healing"框架到"autonomous agent"的创业项目——核心叙事都是同一个:AI 不应该是一次性生成器,它应该能迭代、能纠错、能自我进化。
叙事没问题。但落地的时候,大多数人撞上了同一堵墙:loop 跑不通。
最常见的做法是这样的:
while not success:
    result = llm.call(prompt)
    success = validate(result)
看起来很合理——生成、验证、失败就重来。但实际跑起来你会发现:AI 第一次猜错了选择器,第二次还是猜错,第三次换个方式猜,还是错。不是它不够努力,是它每次都在盲猜。
上篇文章我们总结了 AI 生成测试的五种死法——选择器不存在、时序问题、路由猜错、跨步骤数据依赖、状态污染。这五种死法有一个共同根因:AI 看不到真实页面。
没有数据反馈的 loop,就是盲循环。AI 猜错了,retry 还是猜错,因为它每次循环拿到的信息量是一样的——零。你让一个从来没见过页面的工程师反复重写测试,他也不会突然写对。问题不在循环次数,在信息输入。
所以 loop 的关键不是"循环"这个动作,而是循环中信息是否在增值。每一轮迭代,AI 是否拿到了新的事实?是否能基于事实调整策略?如果答案是否,那 loop 就是空转。
二、能力工具化:把 AI 的"能做"变成"可靠地做"
先说第一层:能力工具化。
什么叫"能力工具化"?一句话:把 AI 的 raw capability 变成结构化、可重复、输出有契约的工具。
举个具体例子。AI "能看页面"——这是 raw capability。你给它一个 URL,它可以通过 CDP 协议访问页面、截图、dump DOM。但这个能力本身不可靠:每次输出的格式不一样,信息密度不一样,下游没法稳定消费。
Recon 做了什么?它把这个 raw capability 工具化了:
输入:workspace + 模块名
流程:启动浏览器 → 登录 → 导航 → 采集四层数据
输出:recon.json(固定结构、固定字段、固定语义)
关键不在"采集"这个动作,而在输出契约。recon.json 的四层结构——选择器探针、页面结构、无障碍树、语义地图——每一层都有明确的字段定义和语义约定。AI 写测试的时候,不需要"看"页面,只需要读 recon.json。它知道按钮叫"提交审核"而不是"提交",知道"技能名称"是必填字段,知道"版本管理"区块是动态渲染的——全部是事实,不是推断。
工具化的核心不是封装,是输出契约。
没有工具化的 loop 是这样的:
轮次 1:AI 看页面 → 输出一段自然语言描述 → 写测试 → 失败
轮次 2:AI 再看页面 → 输出另一段描述 → 改测试 → 还是失败
轮次 3:AI 又看页面 → 输出又不一样 → ...
每次循环,AI 的"看"都是一次性动作,输出不可复现、不可比较、不可积累。下游的测试脚本没法稳定消费这种输出。
工具化之后的 loop 是这样的:
轮次 0:Recon 采集 → recon.json(结构化事实)
轮次 1:AI 读 recon.json → 写测试 → Capture 记录失败上下文
轮次 2:AI 读 Capture 数据 + recon.json → 修复测试 → 通过
每一轮循环,信息都在增值。recon.json 是稳定的事实基座,Capture 数据是增量的事实补充。AI 不需要重新"看"页面——它只需要读结构化数据,基于事实推理。
这就是能力工具化对 loop 的价值:把不可控的 raw capability 变成可控的、可消费的结构化输出,让 loop 中的信息从"每次重新采集"变成"积累式增值"。
三、流程 Skill 化:把人的"怎么做"变成 AI 的"会做"
第二层:流程 Skill 化。
什么叫"流程 Skill 化"?一句话:把人类专家的工作流程编码为 AI 可执行的、可复现的 Skill。
上篇文章我们对比过普通开发和优秀测试工程师的工作方式:
普通开发写测试:  看需求文档 → 写断言 → 交给 CI → 红了再改
优秀测试工程师:  先打开页面 → 看结构 → 设计用例 → 执行 → 观察结果 → 调整
优秀工程师的流程里有一个关键节奏:先观察,再行动,行动后再观察,基于观察再调整。 这就是 ReAct 模式——Reasoning + Acting 交替进行。
但 ReAct 不是 Prompt。你不可能靠一句"请仔细思考后再写测试"就让 AI 走出这个节奏。AI 需要流程骨架来约束它的行为模式,需要数据通道来支撑每一步的推理。
SDD + ReAct 就是这个流程的 Skill 化:
- SDD 定义了输入格式:YAML spec 描述测试意图,结构化、可解析、可生成
- ReAct 定义了行为节奏:Think → Act → Observe → Think → Act → Observe,交替循环
- Recon/Capture/Coverage 提供了数据通道:每一步的推理都有事实数据支撑
三者组合起来,就是一个完整的 Skill——不是一段 Prompt,而是流程骨架 + 数据通道 + 输出契约的组合体。
没有 Skill 化的 loop 是这样的:
轮次 1:AI 自由发挥 → 写了一堆测试 → 大部分失败
轮次 2:AI 自由发挥 → 换了个思路 → 还是大部分失败
轮次 3:AI 自由发挥 → 又换思路 → ...
每次循环,AI 的行为模式都不一样。它可能先写断言再找选择器,可能先猜路由再写导航,可能跳过观察直接行动——流程不可复现,结果不可预测。
Skill 化之后的 loop 是这样的:
轮次 0:Recon(观察)→ 采集事实
轮次 1:Think(读 recon.json)→ Act(写测试)→ Observe(Capture 记录结果)
轮次 2:Think(读 Capture 数据)→ Act(修复测试)→ Observe(验证通过)
每轮循环都走同样的骨架——先观察、再推理、再行动、再观察。AI 在骨架的节点内可以发挥创造力(比如怎么修复一个选择器),但整体节奏是受控的、可复现的。
Skill 化的核心不是 Prompt,是流程骨架 + 数据通道。 Prompt 只约束了语言输出,Skill 约束了行为模式。一个没有流程骨架的 AI,就像一个没有方法论的新人——能力可能很强,但产出不可预测。
四、岗位 Agent 化:把"谁来做"变成"一个角色来做"
第三层:岗位 Agent 化。
什么叫"岗位 Agent 化"?一句话:把人类岗位的角色定义,映射为 AI Agent 的工具集 + Skill 集 + 自主性边界。
上篇文章结尾,我们说 AI 从"一次性生成器"升级为"可以自我进化的测试智能体"。这个升级不是模型变聪明了——同一个模型,盲写的时候首次通过率 30%,有了 Recon/Capture 之后首次通过率 75%。模型没变,变的是它拥有的工具和流程。
测试工程师这个岗位,本质上需要三样东西:
| 岗位需求 | 人类方式 | Agent 方式 |
|---|---|---|
| 看到页面 | 打开浏览器,肉眼观察 | Recon 工具 → recon.json |
| 记住执行过程 | 边跑边看日志,脑中记录 | Capture 工具 → stepSnapshots |
| 发现代码盲区 | 看覆盖率报告 | Coverage 工具 → Istanbul 报告 |
| 知道怎么测 | 先观察再行动的 ReAct 流程 | SDD + ReAct Skill |
| 自主迭代 | 分析失败 → 修改 → 重跑 → 直到通过 | Agent 自主循环,人只审核结果 |
把这五样东西组合起来,就是一个测试 Agent——它拥有工具(Recon/Capture/Coverage)、拥有 Skill(SDD/ReAct)、拥有自主性(可以在人不在的时候自己迭代修复)。
Agent 不是"更强的模型",是工具 + Skill + 自主性的组合。
没有 Agent 化的 loop 是这样的:
AI 写测试 → 失败 → 人看报错 → 人告诉 AI 怎么改 → AI 改 → 人再跑 → 又失败 → 人再看 → ...
人在 loop 里。每一轮迭代都需要人介入——看报错、分析原因、告诉 AI 怎么修。这不是 Agent,这是人在用 AI 当打字机。
Agent 化之后的 loop 是这样的:
Agent 写测试 → 失败 → Agent 读 Capture 数据 → Agent 分析根因 → Agent 修改脚本 → Agent 重跑 → 通过 → 人审核结果
人不在 loop 里。人在 loop 外面——只审核最终结果。Agent 自己完成观察、推理、行动、验证的全流程。
上一篇那个从全红到全绿的案例,就是 Agent 化的实证:AI 自己读 Capture 数据、自己分析根因、自己修改脚本、自己验证结果。全程不需要人工介入。不是模型突然变聪明了,是它有了正确的工具和流程,能承担测试工程师这个岗位的核心职责。
五、三层之间的关系:不是并列,是递进
把三层放在一起看:
能力工具化 → 流程 Skill 化 → 岗位 Agent 化
   地基         骨架          形态
不是并列关系,是递进关系。顺序不能反。
没有工具化的能力,Skill 和 Agent 都建在沙上。你定义了一个"先观察再行动"的流程,但 AI 的"观察"输出每次都不一样——流程走不通。你定义了一个测试 Agent,但它没有 Recon 工具——Agent 还是盲写。
没有 Skill 化的流程,工具就是散装能力。AI 有 Recon、有 Capture、有 Coverage,但不知道什么时候该用哪个、按什么顺序用——工具再多,产出也不可控。
有了工具化的能力和 Skill 化的流程,Agent 化才是水到渠成。工具 + Skill 组合起来,自然就能承担一个岗位的核心职责。不需要额外设计"自主性"——当工具可靠、流程可复现的时候,AI 的自主迭代就是安全的、可控的。
用上一篇的量化数据佐证:
| 指标 | 盲写(无工具无流程) | 有 Recon/Capture(工具化) | 有 ReAct Skill(流程化) | Agent 自愈(岗位化) |
|---|---|---|---|---|
| 首次通过率 | ~30% | ~50% | ~65% | ~75% |
| 人工介入 | 每轮都需要 | 失败时需要 | 关键节点需要 | 只审核结果 |
| 迭代轮次 | 3-5 轮 | 2-3 轮 | 1-2 轮 | 1 轮 |
数字不是精确的分层统计,是趋势判断。但趋势很清楚:每一层叠加,效果都在提升。30% 到 75% 的跃迁,不是模型升级带来的,是三层基础设施叠加带来的。
六、Loop 的本质:信息闭环,不是代码循环
回到 loop 这个概念。
很多人把 loop 理解为代码层面的循环——while not success, retry。但真正的 loop 是信息闭环:输出变成输入,事实驱动推理,每一轮迭代信息都在增值。
上一篇的 Recon/Capture/Coverage,本质上就是三个信息闭环:
Recon 的输出(recon.json)
  → 成为 AI 写测试的输入(事实基座)

Capture 的输出(stepSnapshots)
  → 成为 AI 修复测试的输入(增量事实)

Coverage 的输出(覆盖率盲区)
  → 成为 AI 补充用例的输入(代码层事实)
三个闭环叠加,AI 的信息输入从零变成了三层结构化事实。每一轮 loop,AI 都有新的事实可以消费——不是在同样的信息上反复推理,而是在增量信息上递进推理。
这就是为什么工具化对 loop 如此关键。工具化的核心是输出契约——recon.json 的字段结构、Capture 的快照策略、Coverage 的分支级精度,都是为了让闭环中的信息可消费、可比较、可积累。
没有输出契约的闭环,信息在循环中衰减。AI 第一轮输出一段自然语言描述,第二轮基于这段描述推理——但自然语言不可精确消费,推理质量逐轮下降。就像传话游戏:第一个人说"按钮叫提交审核",传到第五个人变成了"有个提交按钮"——信息失真了。
有输出契约的闭环,信息在循环中增值。recon.json 第一轮采集的是页面初始状态,Capture 第二轮补充的是执行失败时的上下文——两者结构一致、语义一致,AI 可以精确对比、精准推理。信息不是在衰减,是在积累。
Loop 的本质是信息闭环。工具化保证了闭环中的信息质量。Skill 化保证了闭环中的行为节奏。Agent 化保证了闭环可以自主运行。三者缺一,loop 就是空转。
七、超越测试:这个框架的通用性
你可能会问:这套三层框架,只适用于测试场景吗?
不是。我们来看几个其他场景:
代码审查
能力工具化:AST 分析、lint 规则、依赖追踪 → 结构化审查报告
流程 Skill 化:先扫描 → 再深度分析 → 最后综合判断 → 输出审查意见
岗位 Agent 化:Code Review Agent → 自主扫描、分析、判断,人只审核关键发现
没有工具化的代码审查 loop:AI 每次重新读代码,输出一段"这段代码可能有问题"的自然语言——不可复现、不可积累。
工具化之后:AST 分析工具输出结构化的依赖图和模式匹配结果,lint 工具输出规则违反列表——AI 基于事实推理,不是基于印象猜测。
数据分析
能力工具化:SQL 生成/验证工具、Schema 探查工具 → 结构化查询结果
流程 Skill 化:先理解需求 → 探查 Schema → 生成 SQL → 验证执行 → 解释结果
岗位 Agent 化:Data Analyst Agent → 自主探查、生成、验证,人只审核结论
没有工具化的数据分析 loop:AI 每次重新猜表结构、猜字段含义——猜错了就 retry,还是猜错。
工具化之后:Schema 探查工具输出精确的表结构和字段语义,SQL 验证工具输出执行计划和结果样本——AI 基于事实生成查询,不是基于直觉拼 SQL。
运维巡检
能力工具化:监控采集工具、日志分析工具、异常检测工具 → 结构化巡检报告
流程 Skill 化:先采集指标 → 再分析趋势 → 最后判断异常 → 输出巡检结论
岗位 Agent 化:Ops Agent → 自主巡检、分析、告警,人只处理关键异常
每个场景的核心逻辑都是同一个:先工具化,再 Skill 化,最后 Agent 化。顺序不能反。
为什么顺序不能反?因为每一层都是下一层的前提条件。没有工具化的输出契约,Skill 的流程骨架走不通——数据通道断了。没有 Skill 化的流程约束,Agent 的自主性就是散装能力——行为不可控。只有三层递进叠加,loop 才能从空转变成信息闭环,Agent 才能从"更强的模型"变成"可靠的岗位替代"。
写在最后
Loop 是 AI 从"生成器"到"智能体"的关键跃迁。这个判断我认同。
但跃迁的前提是三层基础设施。没有工具化的能力,loop 中的信息不可消费;没有 Skill 化的流程,loop 中的行为不可复现;没有 Agent 化的岗位,loop 中的人不可退出。
三层递进,顺序不能反。这不是理论推演,是工程现场的实证——上一篇那个从全红到全绿的一轮自愈,不是模型变聪明了,是 Recon/Capture/Coverage 工具化了 AI 的感知能力,SDD/ReAct Skill 化了测试工程师的工作流程,三者叠加让 AI 能承担测试这个岗位的核心职责。
所以下次有人跟你讲"我们给 AI 加了个 loop",你可以问一句:loop 底下的能力工具化了吗?流程 Skill 化了吗?如果都没有,那 loop 就是在空转——转得越快,浪费越多。
分寸感就在这里:不是 loop 不重要,是 loop 的前提比 loop 本身更重要。
本文基于 venus-sdd-auto-test 项目的真实演进实践,以及 OpenClaw Agent 网关的多场景落地经验。三层框架(能力工具化 → 流程 Skill 化 → 岗位 Agent 化)已在 E2E 测试、数据分析、运维巡检三个场景中验证通过。